-
Notion 能导出,却未必能恢复:真正该备份的不是文件,而是业务连续性
备份不是恢复
Notion 是一个出色的在线工作空间。我觉得最好的使用方式,就是在上面工作,而不要去想完整备份和恢复这件事。
使用 Notion,多少需要有一点这样的「信仰」。
这也是阻止 Notion 深入一些真正「重要」工作场景的障碍。它可以在许多较浅的工作流里表现得非常出色,但一旦进入「深水区」,很多事情就只能祈祷 Notion 官方帮你搞定一切。
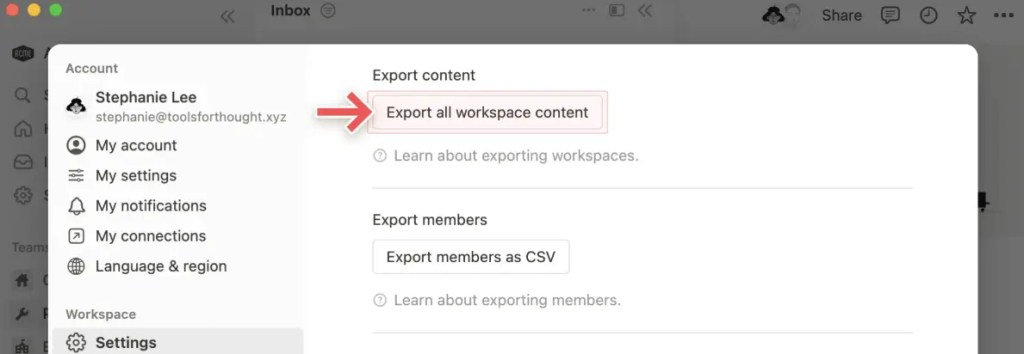
最近,Notion 已经逐步取消了整个工作区的 PDF 导出。不过,这项调整只针对 PDF 格式。工作区仍然可以导出为 HTML、Markdown、CSV,单独页面也仍然可以导出为 PDF。
所以,Notion 并不是不允许你把数据导出来。
但是,也千万不要因此松一口气。我从一开始就没有太看好 Notion 的整套导出机制。
这就像有人给我一把锤子、一把铲子、一把汤勺,再加几十个纸板箱,让我去「打包」一座宫殿。
现在只是告诉我,锤子不能用了,但其他工具仍然可以继续使用。要我说,这并不改变结果。因为整套「打包工具」本身,就不足以完成真正的「恢复」,那么「打包」的意义何在?不如说是「拆卸」?
我们首先要弄清楚,「导出」到底是为了什么?
在我的理解里,至少涉及两件事情:
数据所有权,以及业务连续性。
我们不能把所有数据都押在单一供应商的在线存储上。所谓备份,就是当这个供应商失效时,我仍然有办法保证数据不会丢失,工作还可以继续。
而到了 Notion 这种程度,问题早就不只是「数据存在哪里」了。
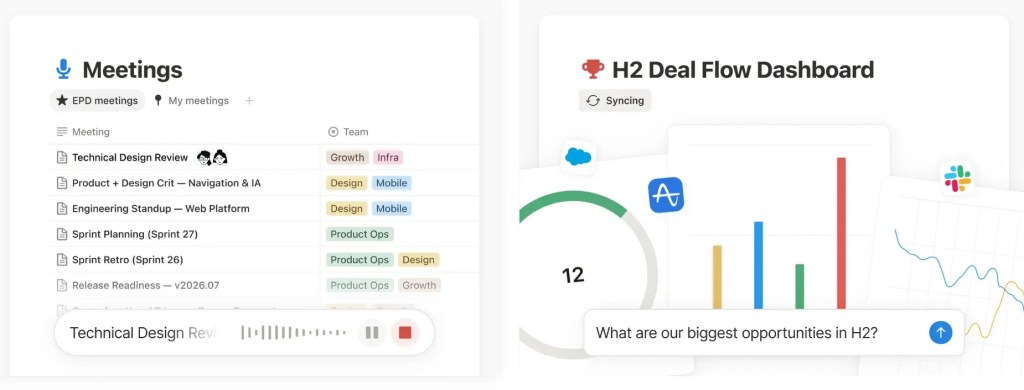
回想起来,Notion 早期更接近一个使用模块搭建页面和工作空间的工具,但发展到今天,它已经变成了一个综合性的工作平台。数据库、项目管理、Wiki、表单、自动化、权限、协作,再加上 AI,这种绑定还在不断加深。
所以设想一下,如果某一天 Notion 暂时失效,问题已经不只是页面和表格还能不能下载下来。
整个工作流都可能一起失效。
这里需要把几个经常混在一起的概念分开:
导出,是把数据拿出来。
备份,是留下可以使用的数据副本。
恢复,是发生问题后,能够恢复原来的工作状态。
迁移,是换一个系统之后,工作仍然能够继续。
这四件事完全不是一回事。
还是回到那座宫殿。你可以用铲子、汤勺和纸板箱,把壁画、柱子、雕像、家具一样一样取出来。但你不能指望靠这些东西,轻松复原出原来的宫殿。
因为真正重要的东西之一,是它们之间的结构关系。Notion 也一样。
这种导出可以把页面、表格、图片、附件等内容取下来,但复杂的映射关系、工作流逻辑、数据库计算、权限,以及越来越重要的 AI 协作上下文,并不会完整地跟着这些文件一起离开。
事实上,Notion 官方自己也明确说明,你无法简单地把导出的整个工作区重新上传,然后直接重建出原来的 Workspace。 更不用说,要把这一切完整迁移到另外一个系统。
换句话说,如果你没有一套不依赖 Notion 的备用方案,那么一旦平台出了严重问题,你的工作就可能实质性停摆。
这不仅仅是 Notion 的问题
不敢说所有,但很大一部分在线 SaaS,尤其是前几年一窝蜂兴起的那些「大而全」的平台,都存在类似的问题:
可以导出数据,却未必能够恢复工作。
换句话说,使用这些平台,多少都需要对平台怀有一点「信仰」。
当然,在严肃的业务场景下,我们还有 SLA、合同、法律责任之类的保障。但这些终究只是协议,并不能替代技术上的可恢复能力。
最可靠的保障,还是自己拥有数据,同时有能力恢复工作。
我相信,类似 Notion 的产品一开始并不是刻意设计成这样的。但随着功能不断增加,尤其是 Database、自动化和 AI 加入以后,事情开始迅速变得复杂。
这就像一家公司。即使我拿到了一个伟大公司的所有纸面文件,也无法据此重新建立这家公司。因为真正宝贵的东西,可能是几十年来形成的组织关系、企业文化、合作默契,以及大量没有被明确写下来的隐性上下文。
至于那些会议记录和财务报表?3个月以后,其中相当部分可能已经只是归档仓库里的历史资料了。
软件平台也是一样。
当一个工作系统足够复杂以后,真正值钱的就不再只是「文件」,而是文件之间的结构、关系、状态,以及围绕这些东西形成的上下文。
所以,既然事情已经发展到了这个阶段,就应该重新思考这个问题。
我不太想给出一个 Old School 的答案,比如加强数据备份和恢复能力、完整保留更多元数据、建立更复杂的灾备机制……
这些当然都有用。但在讨论解决方案以前,我们还应该继续往下挖一层。
AI 正在改变 SaaS 原来的价值
Notion 这类工具,包括很多类似的 SaaS 平台,其实有一个很有意思的尴尬:
它们大多是在 AI 兴起以前设计出来的。
这些产品过去的一个共同商业逻辑,是用便利换取用户留存、平台绑定和付费。
类似乐高积木的页面排版方式、随时在线访问、多人实时编辑、嵌入文档体系的数据库、各种视图和自动化……
这些当然都有价值。但其中相当一部分价值,本质上是我们过去面对数据和流程复杂性时做出的妥协。
以前一个普通用户不会写数据库查询,不会写自动化,不会自己搭接口,也很难把几个不同的软件连接起来。
所以平台说:
把所有东西放进来吧,我给你一个简单的按钮。
于是人们愿意为了这种便利,把自己的数据、结构和工作方式都放进同一个系统。
但 AI 正在改变这个前提。
当 AI 可以帮普通用户整理文件、查询数据、修改文档、建立工作流,甚至直接操作多个不同的软件时,原来很多依赖「把所有东西塞进同一个平台」才能获得的便利,价值就可能越来越弱。
这些 SaaS 必须继续提供更高层面的便利。而那个「更高层面」已经是一个截然不同的竞争领域,周围也早已有后起之秀环伺。
还有另外一个变化。过去生产力软件最重要的问题之一是:解决人与人协作的困境
未来则会越来越多地变成:怎么帮助人与 AI 协作过去的软件设计,把大量精力花在权限、评论、通知、分工、审批,以及各种人与人之间的沟通机制上。
以后很大一部分设计重点,会逐渐转向如何让 AI 理解数据、获得上下文、执行工作,并把结果交还给人。
至少从 Notion 这些年对 AI 的投入来看,它显然已经在往这个方向大幅押注。
所以,数据备份和恢复看起来是一个老生常谈的问题,背后却出现了一个全新的挑战。
只要业务可以继续,现代的用户其实未必那么关心原来的 SaaS 到底提供了多少「便利」,也未必在意接替工作的到底是另外一个软件,还是 AI。 恢复到原来那个 SaaS 上反而是一个掣肘的选项。
所以,这已经超出了导出和备份的范围,开始变成一个如何重新设计「业务连续性」的问题。
替代方案可能反而很直接
那么怎么办?
我的思路并不是「彻底离开 Notion」,而是:
重新安排 Notion 在整个工作系统里的位置。
Notion 是一个很好的工具。但它不应该成为那个唯一承载一切数据、一切结构和一切工作流的工具。
只要做到这一点,备份和恢复的问题反而可以简单很多。
缩减 Notion 的作用,让它做自己擅长的事,而不是全部
Notion 最强的地方,是轻量协作、快速搭建、信息展示和共享。
那就让它专注在这些「浅水区」。项目看板、团队 Wiki、对外页面、临时协作,这些都是很合适的用途。
而真正构成业务核心的东西,比如核心数据、关键逻辑和长期资产,不要只存在 Notion 里面。
把 Notion 当成一个「界面」和「协作层」,而不是唯一的「持久数据层」。 让它只是一个前端。这样,即使有一天失去它,也不再是一场灾难,而只是换一块显示屏。
不要让 AI 成为「平台附庸」
与其依赖某个平台内嵌、无法真正带走的 AI,不如围绕自己的数据,建立自己可以掌控的 AI 协作方式。
现在这样的 AI 工具已经越来越多了。让 AI 直接面对你本地的、开放格式的文档和数据,而不是隔着某个供应商专属的 AI。当然,Notion 大概不会喜欢我这个建议。
从用户角度来说,这意味着 AI 积累的上下文、形成的理解,以及围绕你工作建立起来的能力,都更接近你自己的资产,而不是某个 SaaS 平台的护城河。
未来业务连续性中越来越重要的一部分,可能就是:
AI 上下文的连续性。
换一个模型、换一个 Agent、换一个前端,只要核心数据和上下文还掌握在自己手里,工作就可以继续。这样,你也不必再把某个平台自身的完整恢复能力,当成唯一退路。
本地优先(Local-first)
这是整个方案的地基。
数据的「持久性」应该首先存在于你自己能够完全掌控的地方。
本地磁盘、自己的仓库,以及开放、持久的格式,比如 Markdown、纯文本、SQLite、CSV,这些几十年以后大概率仍然能够被读取的东西。
云端可以是「同步」和「协作」的便利层,但不应该成为唯一的持久化存储层。
Local-first 真正重要的是:即使明天所有 SaaS 都关门,打开自己的电脑,数据依然在那里,工作依然可以继续。 而且,这些数据还可以通过更多更基础的方式进行备份、迁移和恢复。
构建工具链,而不是依赖单一平台
与其把整座宫殿盖在别人提供的一块地基上,不如使用一组可以互相替换的积木,搭建自己的工作流。
每一个环节,包括编辑、存储、同步、检索、AI,都应该尽可能可以被替换。
判断标准其实很简单:假如这个供应商明天消失,替换它需要付出多大代价?
如果答案是「整个业务停摆」,那说明你已经把太多东西押在它身上了。一个健康的工具链,应该做到任何一个环节都可以拔下来换掉,而整体仍然可以继续运转。
这当然意味着前期要接受一点「不方便」。你可能需要接受不那么丝滑、不那么「一站式」的体验。但换来的,是自由和韧性。
最后
Notion 取消整个工作区的 PDF 导出,本身其实是一件小事。甚至可以说,PDF 本来就是几种导出格式里面最不适合恢复工作的一种。
但这件小事提供了一个很好的提醒:你手里那把「导出」工具,从来就不是为了「恢复」准备的。
备份从来不等于恢复。能下载,也不等于能继续工作。
我并不是在针对 Notion。恰恰相反,我觉得只有认清一个工具的边界,才能更加放心地使用它,同时又不必把自己的身家性命一起交给它。
信仰可以有。但信仰不该成为唯一的备份方式。
所以,还在下载那几十个装满壁画、柱子和雕像的纸板箱?还在纠结到底应该选择 PDF、HTML 还是 Markdown?这些其实都不是最重要的。
真正要紧的是:
把宫殿建在自己能够掌控的坚实地基上,而不是建在某个单一供应商的平台里。
-
把屏幕上的问题说清楚,重新认识 ZoomIt :放大、标注、长截图和录屏
电脑上有一类操作,很多人每天都在做:看到一个问题,截张图,圈出位置,发给别人。
现在有了 AI,这件事情似乎变得更有价值了。我就经常截取屏幕、加上标注,然后发给 AI Agent,让它帮忙分析、策划,或者排查问题的原因。很大程度上,把 AI 当作一个同事或工作伙伴来沟通就可以了。但即便如此,基于屏幕内容的沟通仍然很重要。
比如,让 AI 看看某个产品的按钮设计是否合理;或者某个工具打不开、没有按我的意思运行时,附图问问 AI 这是为什么。甚至直接把一堆报错信息扔过去,或者扔过去一张网页截图。(对,我连复制网页地址都懒得弄了。)
有时候一张图就够了。有时候内容超过一屏,需要长截图。还有些问题,用文字解释半天也说不清,但录下十几秒操作,对方马上就明白了。又或者加个箭头、画个框,立刻就容易理解很多。
无论是对人还是对 AI,清楚表达意图的能力都非常重要。
所以,我觉得屏幕工具很值得有一套顺手的工作流。能让人看清楚、指出重点,再把结果带走,发到原本就在用的邮件、聊天工具或 AI 客户端里。
Windows 上有个老牌工具,ZoomIt,我觉得就很适合从这个角度重新认识。
ZoomIt 是什么?一个随时叫出来的屏幕工具
ZoomIt 来自微软 Sysinternals,由 Mark Russinovich 开发,现在也已经整合进 PowerToys。
这个工具的历史相当悠久。Sysinternals 最初是一家开发 Windows 系统工具的独立公司,后来被微软收购。ZoomIt 也一直保留着那种老派实用工具的味道,不太讲究花哨的包装,重点是把事情做好。
很多人对它的印象,仍然是演讲时放大画面、画个红圈的小工具。其实它已经把屏幕放大、标注、截图、滚动长截图、快速录屏和简单视频裁剪放到了一起。实时演讲,只是其中一种用途。
而且,说句公道话,演讲和远程会议通常都有专门的屏幕标注工具,比如 Zoom 就自带类似功能。ZoomIt 的吸引力,在于它离日常操作很近,不局限于演示或开会。无论我眼前是网页、表格、软件设置,还是一条报错,都可以从当前屏幕立刻开始处理。
先说明一下,本文以 Windows 版为主。可以下载独立版本,也可以在 PowerToys 设置中启用 ZoomIt。我发现两者的版本略有不同步,所以具体功能和快捷键,还是以自己安装的版本为准。
另外,ZoomIt 现在也有了原生 macOS 版。微软在 2026 年 7 月 24 日宣布推出 ZoomIt for Mac,包含放大、标注、截图、录屏、视频裁剪和 Panorama 等功能。苹果用户也可以体验了。
但说实话,这种偏实用主义的小工具风格,未必符合所有 macOS 用户的审美。而且 macOS 上也有不少类似的付费工具,选择并不缺乏。
ZoomIt 是免费的,本身不要求订阅云存储服务,也不需要付费账号或邀请。这种老工具诞生的时候,根本没有那些概念,也不需要依赖这些东西。
我个人也很反感有些工具:明明只是一些简单功能,却要收月费、年费。某种程度上,就是赌普通用户不了解还有哪些更多的选择。
放大和标注,一个人用电脑时也用得上
先说最简单的用途:看清一处细节。
比如软件里有一段很小的提示,或者想仔细看某张图的局部。按
Ctrl + 1进入普通放大,滚轮调整倍率,就可以临时把注意力集中到那里。如果需要一边放大、一边继续点菜单或操作应用,用
Ctrl + 4开启 LiveZoom,完成后再按一次退出。这两种模式要分清:普通放大适合停下来观察和标注;实时放大适合继续操作。在普通放大模式下,单击鼠标会进入绘图模式,不要把放大画面里的按钮当成原应用继续点击。
正如前面所说,标注也未必要有观众在场。
自己检查一个页面时,可以临时圈出待检查的位置;整理反馈时,可以给有问题的地方画框。按
Ctrl + 2,就能在不放大的情况下进入绘图。绘图时按住Ctrl拖动可以画矩形,按住Ctrl + Shift拖动可以画箭头,画错了用Ctrl + Z撤销。这里的笔迹属于屏幕上的临时标注,不会修改网页或原文件。
想留下来,就把它变成截图。只用来帮助自己看清楚,用完退出即可。
圈出问题,截图,直接放进邮件和聊天
这是我觉得最容易融入日常的一段流程。
我常用的 Snipaste 也有类似功能,只不过 Snipaste 是先截图,再标注;ZoomIt 是先标注,再截图。甚至两者可以混用,ZoomIt 主打标注,Snipaste 则可以灵活地选取截图区域。
假设我们收到一张表格,需要告诉同事:「总额没有问题,但这里的负责人选错了。」
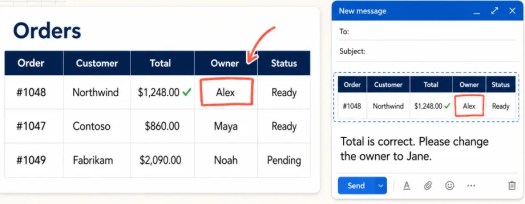
可以按下面的顺序处理:
- 把订单页面调整到合适的显示大小,保留订单名称和负责人字段,让对方知道这是哪一项。
- 按
Ctrl + 2进入绘图,给负责人字段画一个框。 - 在绘图模式下,按
Ctrl + Shift + C裁取需要的画面到剪贴板;也可以用Ctrl + C复制当前截图。 - 退出标注,切回支持图片粘贴的邮件或聊天输入框,按
Ctrl + V。 - 补上一句具体要求:「请把这张订单的负责人改为 Jane。」
如果只是截取一块区域,不需要标注,可以直接用
Ctrl + 6;想直接保存区域截图,用Ctrl + Shift + 6。截图保留足够的上下文,标注只突出一个重点,通常比画满箭头更好理解。
这种方式用在和 AI 交流时,同样有效!
一屏放不下,就用 Panorama 滚动长截图
普通截图遇到长页面,往往会变成好几张图。
一段设置说明、一张较长的清单,或者需要保留上下文的页面,分开截以后,对方还要自己拼出顺序。ZoomIt 的 Panorama 就是为这类滚动内容准备的。
默认按
Ctrl + 8启动,选择要捕获的区域,再滚动内容,完成后按同一快捷键结束。它会把滚动过程中捕获的画面拼接成一张长图,并复制到剪贴板。需要直接保存文件,可以使用长截图保存快捷键,默认为Ctrl + Shift + 8。比如,同一个设置面板里的几组选项需要一起给对方看;或者一段错误信息很长,单张截图装不下;更常见的就是一个网页,一路滚动下去,生成长截图。
操作时可以先让页面加载完整,尽量只框正文区域,缓慢、连续地滚动。保存后检查接缝、重复行和缺失内容。页面里有悬浮栏、动画或边滚边加载的内容时,更值得看一眼结果。
长截图也有一个很现实的问题:发进聊天以后,预览可能被缩成细长的一条。就像下面这样:
因此,留资料时可以保存完整长图;要求对方处理某个具体问题时,另外附一张局部截图,或者在文字里写清楚看哪一段。
长图负责保留上下文,局部图负责让人快速找到重点。
动作说不清,就录十几秒,再裁掉多余时间
我知道有很多简易录屏工具,有段时间我一直用 ScreenToGif。ZoomIt 也有类似的功能。
有些事情,录一段几秒钟的动图,通常比啰嗦地写一串「先点这里,再点那里」更省事。顺便一说,有些高级 AI 也已经能理解视频内容了。我越来越觉得,AI 有潜力成为一个不错的工作伙伴。
ZoomIt 可以录整个屏幕,也可以只录区域或鼠标所在窗口。默认入口分别是
Ctrl + 5、Ctrl + Shift + 5和Ctrl + Alt + 5。结束录制后,内置的 Trim 编辑器可以在保存前截短片段。新版还支持追加其他片段,并在片段之间选择简单的转场,已经不只是剪掉头尾那么简单了。
不过,它仍然是一套偏轻量的录屏处理工具。如果不想把整个桌面录进去,应当在开始时就选择区域或窗口录制;如果需要复杂剪辑,还是要使用专门的视频编辑工具。
输出格式可以选 MP4 或 GIF。我的取舍是:普通操作反馈先考虑 MP4;很短、无声、适合循环看的动作用 GIF。GIF 没有声音,也不意味着文件一定更小。收件端能否直接播放、附件大小是否合适,发送前看一下即可。
如果需要口头说明,检查录制设置里的麦克风输入。只发操作步骤,就确认音频选项符合自己的需要。不要默认录屏一定同时录到了自己的声音。
还有一个小提醒:录屏前最好先关掉可能弹出私人信息的通知,检查桌面上有没有不想让对方看到的内容。屏幕工具越方便,越容易顺手把不该发出去的东西也录进去。
DemoMirror 和实时演讲,是屏幕工具的另一种输出
前面几种用法,最后交出去的是图片或视频。而 DemoMirror 是一个较新的功能,需要当面讲解时,我们交出去的就是实时画面。
DemoMirror 可以把整个屏幕、选定区域或鼠标下的窗口镜像到第二块显示器,并带上鼠标指针。窗口跟随选项 Track window region 会随着窗口移动和改变大小,调整镜像区域。
比如,自己坐在电脑前操作,让旁边的人看另一块显示器;或者做培训时,在笔记本上操作软件,把内容显示到投影屏。当然,也可以配合刚才说的放大和标注。
可以把它理解成 Windows 屏幕镜像功能的加强版,能够选择特定区域或窗口进行共享,而不只是把整个桌面原样投过去。
默认
Ctrl + 9用于启动和停止整屏镜像,Ctrl + Shift + 9选择区域,Ctrl + Alt + 9选择鼠标下的窗口。双屏场景先用 Windows 的扩展显示模式,并确认目标屏幕上的内容正确。最后
如果每天只是偶尔截一张图,现有截图工具已经很顺手,没必要为了功能更多就换掉。
但是,考虑到 ZoomIt 整合了好几种常见的屏幕处理功能,一个工具就能覆盖多种需求,还是值得安装试试。
最可能需要注意的是「快捷键」。ZoomIt 的默认快捷键大多是
Ctrl + 数字,这些组合在其他软件里也常有用途(比如:Chrome),可能需要到设置里换一组。 还有就是,对快捷键熟练后,我们的操作会很方便很快速,但前期适应过程会比较痛苦,而其它精美 GUI的截图工具,就显得很友好。另外需要注意的是,PowerToys 和 ZoomIt 独立版,不要同时启用。为避免快捷键、托盘和进程冲突,选择其中一种使用即可。
我觉得 ZoomIt 最有价值的地方是,非常简单实用,没有花哨的修饰,以解决实际日常问题为主。
这些零碎的屏幕处理需求,可以随手解决;处理完后,图片和视频就能直接扔进邮件、聊天、文档或 AI Agent 里。真的是:效率拉满。
-
Prompt 正在从一次性输入,变成可以复用的「工作规则」,Google 开始测试 Workspace Skills
很多人每天都在重复写同一类 Prompt。起初可能只是一句「把这几份记录整理成报告。」然后会不停修正提示词,直到满意,下一次最好从已经更新过的版本开始,有可能再修正。随着时间推移,Prompt 会和工作流紧密贴和在一起,成为某种「最佳实践」。
我周围有些人,已经有意识的在收集保存自己的「提示词」了,防止每次「从零开始」和 AI 交流。 事实上 现在许多 AI 应用带有记忆,即使我们的要求比较模糊,也能根据以往的修改建议自行迭代优化,并且记住复用。 甚至有人在做这类产品,这我觉得倒没有特别的必要。
而 Google 最近在 Workspace Studio 里推出的 Skills 测试,就很好地印证了这种变化,Prompt 将离开聊天框,从一次性文字变成可以保存、命名、共享和调用的长期工作资产。 我的理解是,Skill 就是用户能意识得到,而且可复用的 Prompt。
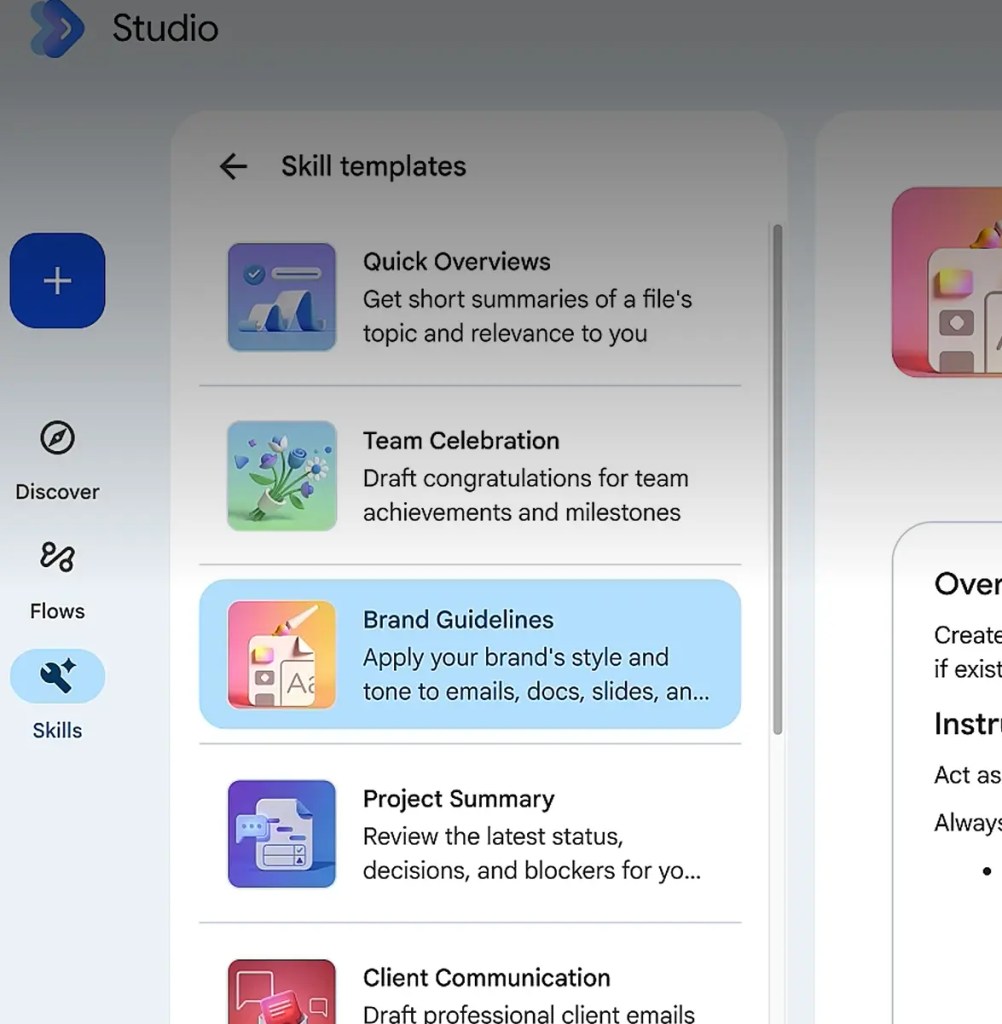
Skill 更接近过去的 Office Template 或者 Macro 之类的东西了,只是普通人建立规则的门槛低了很多,如果这些规则只留在某一段聊天记录里,它们就很难被稳定复用,也无法交给其他人复用。从这个角度来说,Prompt 实际已经开始承担 SOP 的功能。
Google Workspace Skills 做了什么
Google 在 2026 年先为 Chrome 推出 Skills,让用户把 Gemini 侧边栏里验证过的 Prompt 保存成一键工具,在不同网页上重复使用。 只要用 / 就可以调出 Skills 列表,这也是主流的做法。
到了 8 月,Workspace Studio 里的 Skills 又向前走了一步。
用户可以建立一套可复用指令,让 Gemini 使用团队规则、模板和 Google Drive 中的参考文件来完成任务。Skill 可以被分享给团队,也可以通过
@提及,在 Gmail、Docs、Slides、Drive 和 Chat 的 Gemini 侧边栏中调用。例如,一家公司可以建立「客户提案」Skill,里面不只是写一句「帮我制作提案」,还可以包含:
- 先从当前邮件和 Drive 文件提取客户背景;
- 必须使用公司批准的品牌语气;
- 按照指定 Slides 模板生成;
……
这时,Prompt 已经不是一次输入,而是一套随时可以被调用的「工作流规则」了。
Skill 不只是保存了一段 Prompt
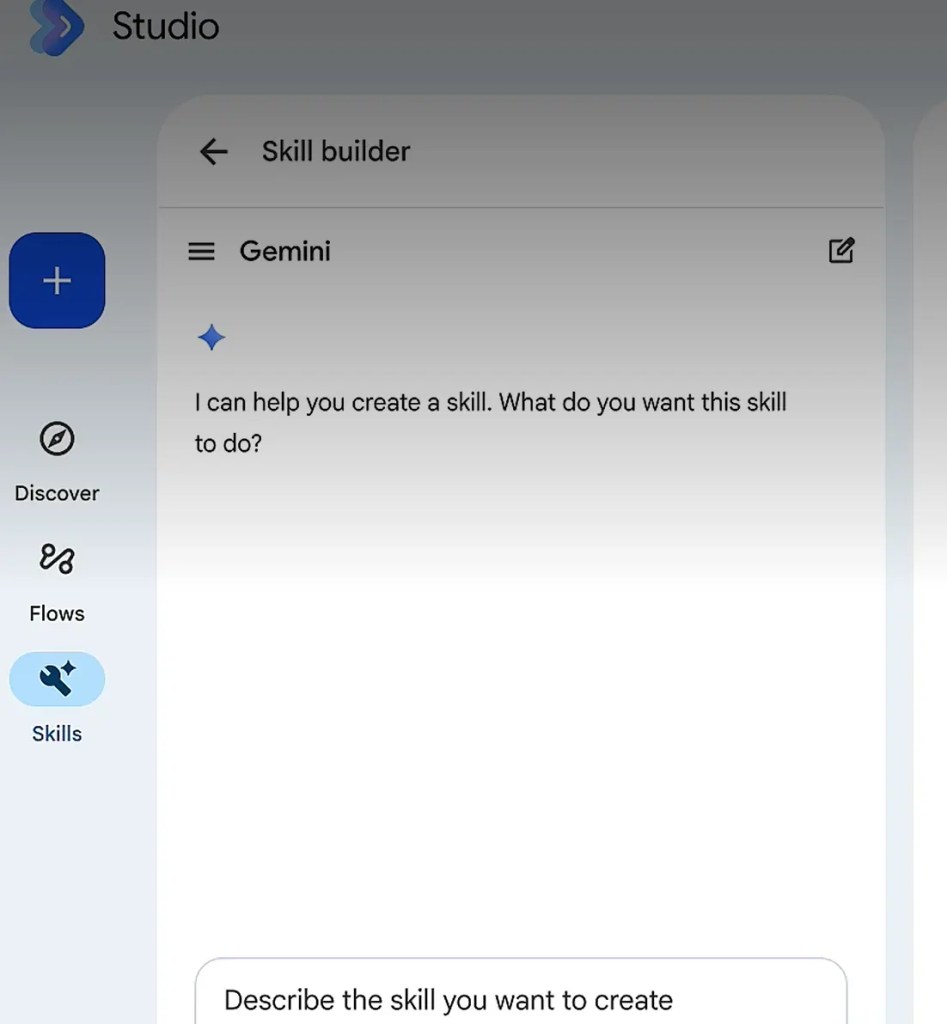
最简单的 Prompt Library,只是把常用文字存起来,使用时再粘贴。
Google 由于有 Workspace 生态, Skill 通常至可以支持:Instructions、References 和 Template。
Instructions 规定 AI 怎样做。它包括步骤、语气、判断条件、禁区和验收标准。
References 提供完成任务时应该相信的资料。例如品牌手册、产品价格、以往周报、合同条款和研究数据。这样 AI 不必每次重新询问背景,也不应该随意用互联网内容替代内部标准。
Template 规定结果应该长什么样。它可以是一份 Docs 结构、一套 Slides 母版、一张表格,或者一封已经经过团队认可的客户邮件。
把三者放在一起,Skill 才从「更长的 Prompt」变成一种完整的可复用能力。虽然设置迭代和调整会费些力,但一旦设置成熟,后续就能大幅提高生产力。
我能立刻想到的场景
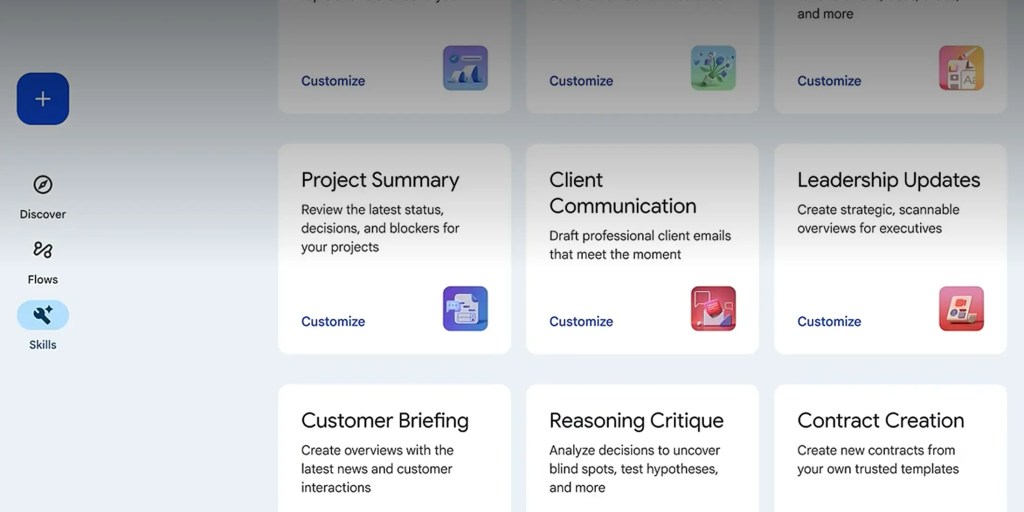
报告汇总
把本周会议记录、项目文档和任务更新作为 References,要求 AI 固定输出「完成事项、延期、风险、计划」,并给每条结论保留来源链接。
只需要调用 Skill,不必重新解释格式和汇报口径。
如果大量文档表格和邮件甚至日历事项都在Google Workspace 生态里的话,这种报告汇总简直是杀手级别的场景。 这也是 Notion 费了那么大力气,收购了一堆办公应用却很难做到的事情。
提案
前面我举的那个例子就是提案,把品牌规范、标准服务范围、成功案例和 Slides 模板组合起来。AI 根据客户邮件生成第一版提案,但特殊的价格和承诺只能来自额外的信息,需要人工介入和调整。
肯定减少了大量复制粘贴,当然销售与法务检查还是必须的。
客户回复
这个也很实用,规定语气、响应时限、可承诺范围和升级条件。普通咨询生成草稿,涉及退款、法律或安全问题时只做分类并转交人工。
感觉重点是让AI 写得礼貌并不难,难的是要清楚什么时候不要自做主张回答去转交人工。
研究模板
要求 AI 先区分官方资料、媒体报道和用户反馈;每个关键结论都附来源;事实与推测分开;最后列出仍未验证的问题。
我觉得很有潜力,但需要反复迭代,把一套适合自己的方法逐渐固化为一个模板。尽管 AI 也不能保证研究一定正确,需要自己核对,这仍旧节约了大量的时间。
现在仍然只是趋势的早期阶段
Workspace Studio Skills 目前只向加入 Gemini Beta 的 Workspace 客户开放,能否使用还取决于管理员设置。不同账号和产品里的 Skills 也并不完全相同:Chrome Skills 更像网页上的 Prompt 快捷方式,Workspace Studio Skills 则可以结合团队规则、模板、资料和流程。
这意味着,大多数普通用户现在未必马上用得到完整版本。产品名称和入口也很可能继续变化。
但我感觉趋势已经很清楚。 Claude、Codex、Gemini 和越来越多生产力软件,都在用各自方式保存可复用 Instructions、工具和参考资料。大家使用的格式还没有统一,背后的方向却一致:AI 不再只处理一次对话,而是开始记住「这类工作应该怎样做」。
最后
Google Workspace Studio Skills 将来如果能普及,应该会成为事实标准。 微软 Office 系列应该也会跟上,而现在微软那套 Copliot Flow ,Power Automate 什么的,太复杂了, Google 的Skill 就很平易近人,任何人都可以上手设置。
不过我最期待的是,第三方开源本地优先的文档产品可以真正跟上这个潮流,让用户不仅可以享受 AI 便利,也没有锁死在供应商平台上的风险。说到这点,我个人还是强烈建议,手头要有一份最新版的 AI Skill 提示词,和相关资料副本(比如:模板文档),这才能方便切换到其它 AI 应用上。而不是偷懒把一切都交给 一个供应商或者一个应用。
-
Apple Notes 本来就该是这个样子,Notomo 给它装上了一个现代笔记的扩展
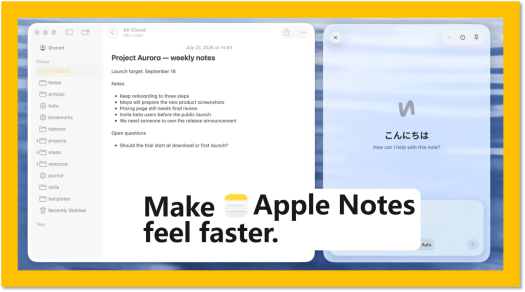
很多人折腾完一圈笔记工具之后,最后还是会回到 Apple Notes。
原因也挺简单。Apple Notes 已经出厂装在每一台 Mac、iPhone 和 iPad 里,打开就能记录,扫描、手写、附件、共享一应俱全,而且 iCloud 同步也很自然,还是免费的。
对于大多数人来说,这些基础体验已经比许多付费订阅的云笔记好用得多,虽然它依旧是一个相对封闭的系统。
但 Apple Notes 的问题也很明显。
它明明拥有几乎最好的系统入口,却一直缺少一些现代笔记工具早就应该具备的能力,比如 Markdown 快捷输入、命令面板、模板、快速跳转,以及可以重复使用的 AI 工作流,也就是类似 Skill、Artifact 这样的机制。
这也给了 Bear 这类笔记工具崛起的空间。它们绕开 Apple 自带的笔记系统,索性自建一整套编辑和数据机制,因此可以更自由地加入各种功能和体验上的改进,虽然很多时候,它们本身依旧是另一个封闭系统。
最近出现了一款比较新的小工具,Notomo,选择了一条很聪明的路线。
它不再重新做一个笔记 App,也不要求用户迁移资料,而是直接给 Mac 上的 Apple Notes 装了一个「扩展程序」。
Notomo 是怎么做的?
Notomo 官方把自己称为 Apple Notes 的 companion。
安装之后,我们写笔记的地方依然是 Apple Notes,资料仍然保存在原来的账户里。Notomo 不会建立另一套数据库,也不要求迁移旧笔记。
它借助 macOS 的辅助功能权限和 Apple Events,判断当前打开的是哪篇笔记、光标在哪里、选中了哪段文字,然后把自己的工具栏、命令面板和 AI 助手放在 Apple Notes 旁边。
操作结束之后,格式和文字依然写回原来的笔记。
我以前介绍过另一款工具 ProNote,走的也是类似的路线。
这种感觉很像浏览器扩展,只不过这次被扩展的是一个原本没有插件系统的 Mac 原生 App。
它最大的好处,是几乎没有迁移成本。
即使以后不再使用 Notomo,原来的笔记也不会消失,Apple Notes 原本的同步、协作和移动端体验也都会保留下来。
Apple Notes 本来就应该是这个样子
Notomo 首先补上的,是类似 Markdown 的快捷输入体验。
在一行开头输入
#、##、>、[]或代码块标记,它会自动将这些内容转换成 Apple Notes 原生的标题、引用、待办和代码块格式。需要注意的是,Notomo 并没有把 Apple Notes 变成真正的 Markdown 编辑器。
最后保存下来的,仍然是 Apple Notes 原生的富文本格式。
从 macOS Tahoe 26 开始,Apple Notes 已经可以导入和导出 Markdown,但那个功能主要解决的是文件交换问题。Notomo 解决的,则是写作过程中直接使用 Markdown 语法输入的体验。
除此之外,它还加入了斜杠命令、行内工具栏、Quick Open 和命令面板。
- 输入
/,可以插入格式、日期、时间、模板,或者调用 AI。 - 按下
⌘O,可以快速搜索笔记和文件夹。 - 命令面板则可以集中处理复制链接、复制为 Markdown、导出等操作。
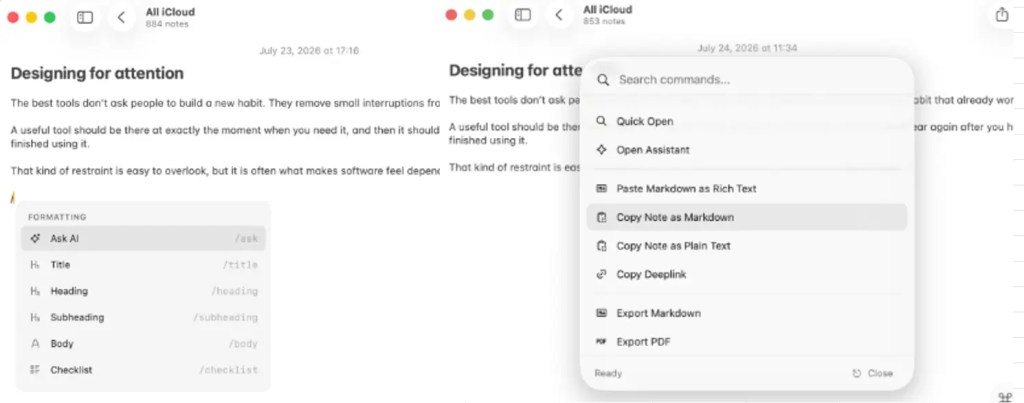
模板的实现方式也很自然。
用户只需要在 Apple Notes 中建立一个顶层的
Templates文件夹,其中每一篇普通笔记都可以成为一个模板,之后再通过斜杠命令插入即可。这些功能单独来看都不算新鲜。
但把它们放回 Apple Notes 之后,会产生一种很强烈的感觉:
Apple Notes 本来就应该允许用户只靠键盘完成格式调整,通过统一的 Slash 入口调用命令,并且让常用模板可以被反复使用。
这些能力如今在不少付费订阅的笔记软件里,早就已经司空见惯。
我甚至觉得,Apple 要不干脆把 Bear 收购算了,说不定真能大幅改善 Apple Notes 的体验。
在这之前,Notomo 和我之前介绍过的 ProNote,都会有继续存在的意义。
Obsidian 已经定义了现代笔记工具的部分标准
为什么我们会觉得这些功能已经理所当然?
很大程度上,是因为 Obsidian(下图为 Obsidian 的Command Palettee)、Notion、Craft、Bear 这些现代笔记工具,已经改变了用户对于「笔记软件应该是什么样」的预期。
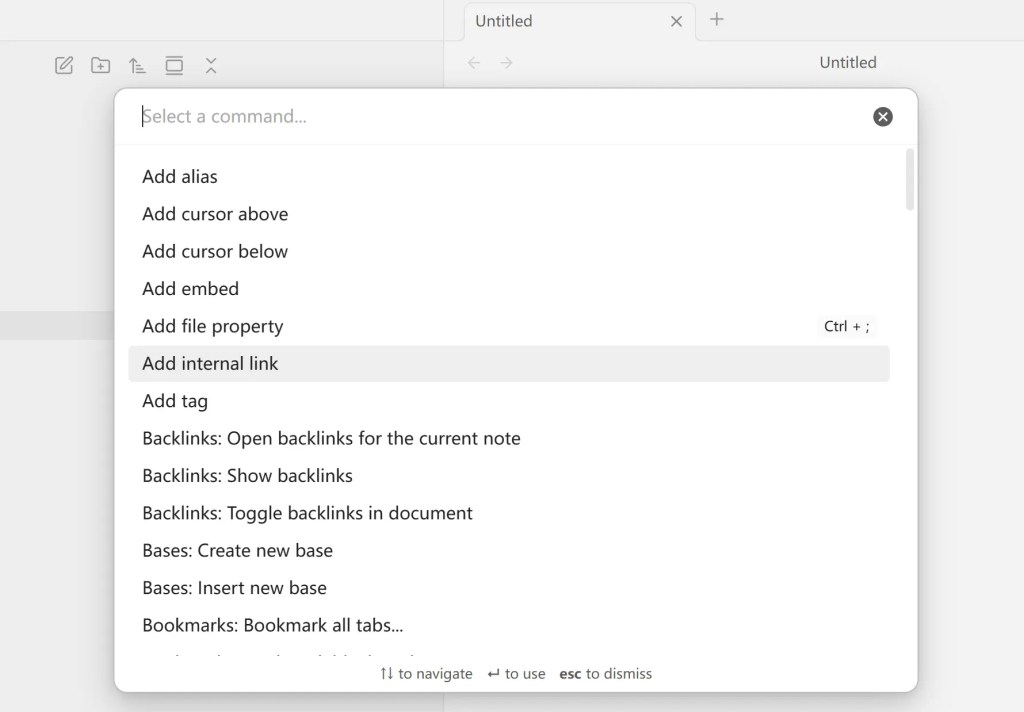
比如 Obsidian,它不只是普及了 Markdown 和双向链接,也让很多人习惯了一套新的操作逻辑。
命令面板负责快速调用功能,模板负责复用结构,插件负责扩展能力,普通文本和链接,则让内容可以继续被其他工具处理。
现在回头来看,一款现代笔记工具是否好用,早就已经不只取决于能不能输入文字、插入图片和建立文件夹。
我们还会期待键盘优先的操作方式、统一的搜索和命令入口、可以复用的模板,以及让 AI 和自动化工具参与工作流的能力。
Apple Notes 在同步、扫描、手写、分享和系统集成方面一直很强,但在「可扩展」这件事情上却始终非常保守。
它没有 Obsidian 那样的插件生态,也很难让用户按照自己的习惯重新组织操作。
Notomo 做的事情,其实就是把现代笔记工具已经形成的一部分标准,重新移植回 Apple Notes。
Skills 让普通笔记也可以执行 AI 操作
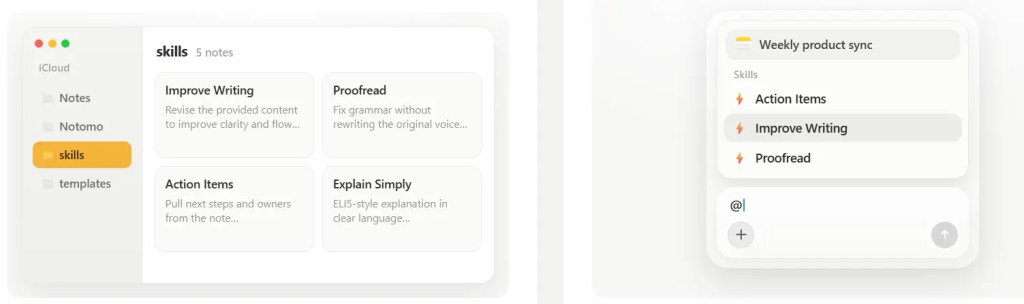
Notomo 中比较符合现在 AI 使用习惯的一项功能,是 Skills。
用户可以在 Apple Notes 里建立一个顶层的
Skills文件夹,每一篇普通笔记都可以保存一套指令。例如:
- 检查语法和拼写
- 提取会议中的任务
- 总结文章
- 按照固定的语气改写内容
- 根据预设结构整理笔记
使用 AI 助手时,可以用
@引用当前笔记、当前选区或者某个 Skill,然后交给自己选择的模型处理。因为这些 Skills 本身就保存在 Apple Notes 里,所以它们可以像普通笔记一样编辑和同步,不需要额外维护一套 Prompt Library。
这件事其实很有意思。
过去我们经常把 Prompt 当成一次性的输入内容,但随着 AI 更深入地进入日常工作流,这些 Prompt 越来越像模板、宏或者自动化指令。
把它们当成普通笔记保存,反而是一种非常容易理解的方式。
Notomo 还可以把这些 Skills 带到 Apple Notes 之外。
例如,在 Mail、Safari 或其他支持文本输入的应用中选中文字,然后运行来自 Apple Notes「Skills」文件夹里的 Skill,最后选择「替换选区」或者「复制处理结果」。
Notomo 提供了全局快捷键
⌥⌘P,也提供了 PopClip 扩展作为入口。另外一个我比较喜欢的地方,是 Notomo 自己并不销售 AI Credits。
用户可以连接自己的账户或者 API Key。不过这里也需要区分一下,BYOK 并不等于本地 AI。主动提交给 AI 的内容,依然会发送给你所选择的模型提供商。
这种「扩展」方式也有明显代价
Notomo 当然远非完美。
我个人其实很喜欢它的设计思路,但对于这种依赖非官方机制实现的「扩展」,还是会心存一些隔阂。
第一,它依赖辅助功能权限、Apple Events、活动窗口、光标和选区。
从官方更新记录来看,Notomo 一直在修复窗口跟踪、快捷键、输入法、焦点恢复和 AI 回写相关的问题。
暂且不论其中可能存在的隐私风险,单是 macOS 或 Apple Notes 的一次更新,就有可能让其中某些操作暂时失灵。
这种问题不是 Notomo 独有,只要工具建立在另一个没有正式插件机制的 App 之上,就很难完全避免。
第二,增强功能只存在于 Mac。
笔记和模板当然可以通过 iCloud 同步到 iPhone 和 iPad,但 Markdown 快捷输入、命令面板和 Notomo AI 这些增强能力,并不会一起同步过去。
所以从跨设备体验来看,它依然是不完整的。
第三,底层数据依旧属于 Apple Notes。
Notomo 可以导出 Markdown,却没有把整个资料库变成一组用户可以直接管理的
.md文件。如果你重视 File over App、Git 版本管理,或者希望 AI Agent 能够直接读写本地资料库,那么 Obsidian 这类真正基于本地文件的工具,依然更加合适。
最后
Apple 的思路一直很有意思。
它经常会先观察第三方 App 对系统原生 App 做了哪些补强,等某种交互方式被验证之后,再把其中的一部分重新做成原生功能。
所以说不定某一天,Notomo 现在这些「小心思」,真的会变成 Apple Notes 的原生能力。毕竟 Apple Notes 已经有非常好的同步、移动端体验和系统入口。它缺少的只是让用户自己定义「怎么写、怎么调用、怎么复用、怎么自动化」。
Notomo 把这一层实现了出来。
如果大家本来就喜欢把 Apple Notes 作为整个笔记体系的核心,又觉得它的操作方式这些年始终有点跟不上现代笔记工具,那么 Notomo 值得尝试一下,也可以试一下 ProNote(以前介绍的,类似机制)。
但如果大家真正看重的是开放文件格式、长期可迁移性、Git、自动化,以及未来让 AI Agent 直接处理整个知识库,那么与其继续给 Apple Notes 加扩展,可能还是直接考虑 Obsidian 之类的第三方工具更加合适。
- 输入
-
收件箱不是仓库:从 Obsidian 到 Todoist 的效率系统反思
最近读到 Stéphane Sulikowski 的一篇文章《The Inbox Is the Most Dangerous Folder in My Obsidian Vault》,文章开篇就打动了我:
「我的收件箱之所以有用,恰恰在于它不应该是一个让人感到舒服的地方。如果一条记录在里面停留太久,那一定是哪里出了问题。」
原作者讨论的是他的知识管理工具 Obsidian,而作为一个深度依赖 Todoist 多年的任务管理用户,我却在屏幕前停顿了很久。
因为在很长一段时间里,我的 Todoist 收件箱(Inbox)正是那个看起来最井井有条、实则最危险的「数字沼泽」。
无论是在笔记软件里收集文章和灵感,还是在待办工具里捕捉任务和念头,我们几乎都在重复同一种自欺欺人的游戏:
把「收集」当成了「行动」,把「推迟判断」当成了「掌控生活」。
我称之为「战术性拖延」,这个说法也许有些夸张,却准确描述了我的真实状态。
收集的幻觉,廉价而即时的多巴胺奖励
现在的生产力工具,把「捕捉(Capture)」做得太丝滑了。
在 Mac 上按下一个全局快捷键,或者在手机锁屏小部件上轻轻一点,Todoist 的快速添加窗口就会弹出来。
在电梯里、会议间隙,或者浏览网页的某个瞬间,任何一个闪过的念头都能被迅速捕获:
- 看一看那个新的开源项目
- 重构个人知识库的工作流程
- 读完那篇深度长文
- 尝试一下某某产品
敲下回车,弹窗消失,任务落入 Inbox。
在那个瞬间,大脑仿佛获得了一次即时的多巴胺奖励,让我产生一种「这件事已经被妥善处理了」的释怀感和掌控感。
我会觉得自己雷厉风行、高效且自律,仿佛只要记下来,这件事就已经完成了一半。
但正如 Stéphane 在文章中犀利指出的:
「记录不是免费的,它只是被推迟的判断(Deferred Judgment)。」
每一次轻率的收集,本质上都是在给「未来的自己」派发一张无薪加班的工单。
未来的你需要重新查看这条记录,回忆当时的上下文,搞清楚那句话究竟是什么意思,判断它是否值得执行,拆解下一步行动,再为它分配时间。或者,在拖延了三个月之后,羞愧地承认,它其实根本没有那么重要。
收集并没有解决任何问题,它只是把认知负担延期交付了。
数字垃圾场与认知负债
如果一个系统的流入速度远大于流出速度,那么崩溃只是时间问题。
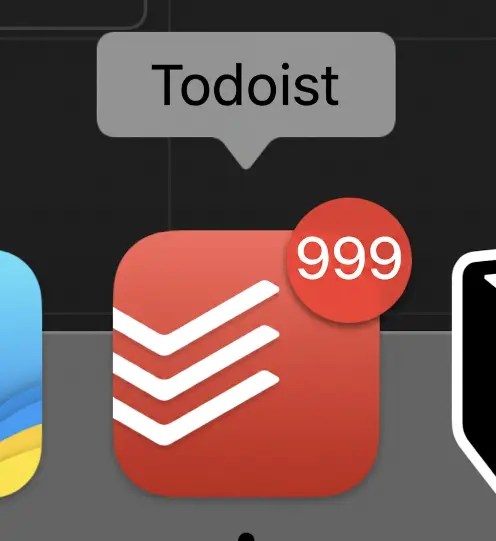
我的 Todoist 收件箱曾经堆积了大量待办事项:
- 有些任务是半年前随手记下的灵光一闪,现在看起来如同天书,完全想不起当时的上下文;
- 有些是某篇高赞文章的链接,当时觉得自己「非读不可」,现在却连点开的欲望都没有;
- 还有大量模糊的目标,准确地说,它们既没有被分解,我也懒得分解。
收件箱之所以是一个「礼貌的数字垃圾场」,是因为里面的每一条记录看起来都有价值,也都有被保留的理由,但它们并没有真正推动任何行动。
当收件箱膨胀到这个程度时,系统的性质就变了。
原本希望它成为一个「第二大脑」,我其实很讨厌这种说法,现在更讨厌了,结果它却变成了「大脑以外的负担」。
每天打开 Todoist,光是看到收件箱,或者「已逾期(Overdue)」旁边那个两位数的红色角标,心里就会升起一股隐隐的内疚和压迫感。
这些堆积在 Inbox 里的项目,都是一笔笔微型负债(Tiny Liabilities)。
它们污染视线,稀释我们对真正重要事情的注意力,把原本应该用于执行任务的精力,白白消耗在「我要不要做这个」和「这个应该放在哪里」的反复纠结中。
收件箱只是过道
痛定思痛之后,我重新审视了收件箱的定位。
原文作者 Stéphane 提到了一个非常形象的比喻:
收件箱就像门厅玄关处放钥匙的托盘,是进门之后做出决策之前的临时存放处。它不是起居室,更不是储藏室。
东西可以穿过收件箱,但不应该住在收件箱里。
在 Todoist 中,为了不让 Inbox 重新沦为泥潭,我给自己确立了一套严格的处理准则。
清空收件箱时,每条任务都必须接受以下四种「判决」之一。
1. 删除(Drop)
这是最重要、也最容易被低估的动作。
重新审视那条灵光一现,问问自己:
「如果我现在删掉它,我的生活会受到任何影响吗?」
如果答案是否定的,或者那个瞬间的热情已经消退,就立刻按下快捷键,把它删掉。
承认一个念头不值得执行,不仅不是失败,反而是对注意力最高级的保护。
我们不需要为每一个转瞬即逝的想法负责,也没有义务把每一种可能性都变成现实。
2. 立即执行(Do)
如果一条待办事项只需要两分钟,比如回复一封邮件、支付一笔账单、确认一条快递信息,就不要再给它分配项目、标签和日期。
立刻把它做完,然后勾选完成。
不要让一个原本只需要两分钟的动作,因为复杂的任务管理流程,变成一项需要反复查看和重新判断的心理负担。
3. 明确并归类(Clarify & Move)
如果是一件必须完成的事情,那么收件箱绝对不能成为它的终点。
你不能只在里面留下一条名为「写年度总结」的任务,因为它只是一个模糊的目标,而不是可以立即执行的行动。
你必须把它动词化、具象化,比如:
「列出年度总结中的 3 项核心成果。」
或者:
「围绕 3 项核心成果,拟定年度总结大纲。」
接下来,为它设定截止日期和优先级,再将它移入对应的「工作」项目。
收件箱可以接受粗糙的念头,但一条记录在离开收件箱时,必须已经变成清晰的行动指令。
4. 留待未来(Someday / Maybe)
有些想法并非毫无价值,只是暂时没有优先级。
例如想看的电影、准备阅读的书、值得关注的冷门工具,以及未来也许可以尝试的个人项目。
对于这些「以后有空可以看看,但目前并不重要」的内容,我不会让它们继续留在主视线里,而是将它们移入专门的「未来/也许」项目。
不给日期,不设提醒,也不让它们产生红色角标,确保它们彻底离开日常工作流。
这其实是一种取巧,相当于给 Inbox 再设置一个 Inbox。
但两者之间存在一个重要区别,真正的收件箱要求我及时做出判断,而「未来/也许」列表允许我暂时忘掉那些内容。
即使以后再也没有打开过这个列表,我的生活也不会因此遭受什么损失。
战胜对丢弃的恐惧
很多时候,我们不敢清空收件箱,本质上是因为 FOMO(害怕错过)。
我们害怕删掉那篇想读的文章后,会错过某次关键的认知升级;我们害怕删掉那个模糊的项目想法后,会丢失一个可能改变职业生涯的机会。
我们总觉得:
「万一以后有用呢?」
但事实往往是残酷的。
如果记下后的 48 小时内,都没有重新意识到它的重要性,那么 48 天后,它大概率只会变成一串失去上下文的字符。
一个好的任务系统,衡量标准从来不是你记录了多少宏伟的计划,而是它能否在每天早晨,为你提供一份极度清晰、几乎不会带来心理阻力的执行清单。
每一次果断删除,都是在为真正重要的任务腾出带宽。
你所放弃的,不是可能性,而是那些关于未来的不切实际的幻想;你所保留的,才是自己真正能够支配的现实生活。
最后
回到最初的那句话:
「收件箱不应该是一个让人感到舒服的地方。」
如果你的 Todoist 收件箱让你感到舒适、安逸,甚至成了一个可以随时往里丢东西的垃圾场,那么它就已经变成了整个系统里最危险的角落。
我依然离不开 Todoist 的快速收集功能。
在灵感出现或突发事务到来时,我仍然会毫不犹豫地把它们放进 Inbox。因为收件箱真正的价值,在于保护当下的专注,避免琐事打断正在进行的心流。
但我也会时刻提醒自己:
快速收集只会产生一笔注意力负债,并不会自动转化为认知的资产。
-
Omarchy 为什么深得我心?用「主厨精选」对抗 Linux 的「选择过多」
我一直认为,「有选择」是一件好事,但极端的「选择过多」却可能成为一场灾难。Linux 就存在这个问题。
很多人以为,Linux 最大的使用门槛是「命令行」这种工作方式。诚然,这是一个问题,不过如今 Linux 上也已经有了许多设计精美的 GUI 应用,用户也并不是非得接触命令行。
真正的问题在于「碎片化」,或者换句话说,「选择过多」。
Linux 有无数个发行版、不同的软件生态与技术分支、微妙的兼容性问题,以及截然不同的界面风格和使用习惯。对于资深 Linux 用户来说,这些都不是问题。因为看透这些差异之后就会发现,它们背后都是相同的 Linux 内核。至于那些纷杂的界面与操作,不过是外在表象而已,颇有几分佛法的意味。
但对于初学者、日常用户,乃至拥有其他操作系统使用经验的开发者而言,Linux 仍然是一个不太容易接近的操作系统。
真正开始使用 Linux 后,人们会发现,更常见的障碍其实是:几乎每一件事,都有太多种做法。 而网上的不同资料,往往只适用于各自特定的环境。
先不说发行版之间的差别,桌面环境应该选择 GNOME 还是 KDE?要不要使用 Hyprland?状态栏用什么?启动器、终端、文件管理器、剪贴板和截图工具又该怎么选?
每个工具背后还有各自的主题、插件、快捷键与配置选项,有时甚至需要修改千奇百怪的配置文件。
可以说,Linux 给了用户非常大的自由,「拥有选择权」的确是一种自由。不过,用户的注意力也可能被过多的「选择」淹没。
Omarchy 带来了什么?
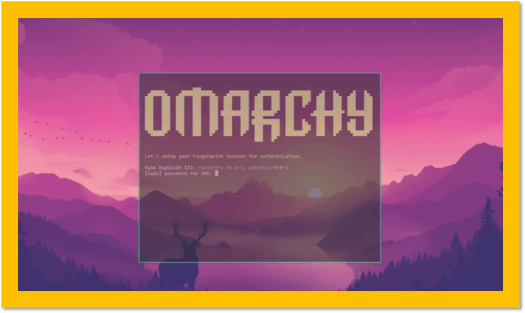
如果理解日本料理中的 Omakase,也就是所谓的「主厨推荐」,我觉得就不难理解 Omarchy。
Omarchy 是一个预先搭配好各种应用并完成环境配置、力求做到「开箱即用」的操作系统。
其实,Windows 和 macOS 在某种程度上都是「开箱即用」的操作系统。它们各自拥有一套相对稳定的界面与设计风格,甚至内置了一些基本应用。
总体而言,macOS 在整体搭配与一致性方面做得更好,也更受用户喜爱。相比之下,Windows 的整体搭配显得随意一些,用户通常仍然需要自行安装应用、调整设置并补充一些功能。
Omarchy 也试图沿着这个方向发展。它提供了一套预先精选的方案,让用户不必再为琐碎的配置费心。
当然,「主厨推荐」本身也很有讲究,体现的是选择者的品味。
Omarchy 官方甚至很直白地表示,它不是简单地预装一堆软件,而是「everything I use」,基本上就是「主厨」本人每天使用的那套电脑环境。
这就要说到 Omarchy 背后的「主厨」,DHH,也就是 David Heinemeier Hansson。
他是 Basecamp 和 HEY 背后的公司 37signals 的共同所有者和 CTO,也是 Ruby on Rails 的创造者。后来,他还开发了 Hotwire、Kamal 等一系列工具。
2024 年,他开始公开推动 37signals 的开发团队从长期使用的 Mac 转向 Linux。随后,他推出了运行在 Ubuntu 上的 Omakub,并进一步发展出基于 Arch Linux 和 Hyprland 的 Omarchy。
2026 年 8 月,Omarchy 4,也就是 Quattro,正式发布。它一如既往地替用户做好了大部分决定。
的确,用户不应该被迫反复处理那些已经可以由别人代为做好的决定。
为什么我会欣赏 Omarchy
简单来说,它非常符合我个人的使用习惯和理念。
根据我的实际体验,Omarchy 提供的许多「预设」,本来就有不少是我正在使用并积极实践的方案。
例如,Hyprland 和 Quickshell 组成的桌面与窗口管理环境非常高效。我甚至一直在其他操作系统中寻找类似的替代方案。
无论是窗口平铺还是桌面切换,体验都堪称一流。它没有过多花哨的装饰动画,一切都很流畅。这才是真正的生产力系统。
最新的 Quattro 更进一步。以前分散在 Waybar、Walker、Mako、SwayOSD、hyprlock 等不同组件中的状态栏、启动器、通知、锁屏和控制面板,现在被整合进一个基于 Quickshell 的统一桌面环境。
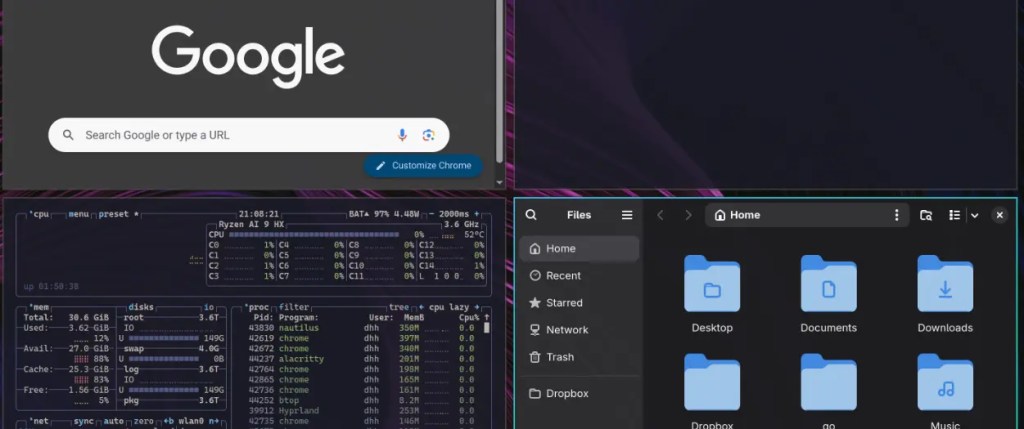
Omarchy 还内置了许多应用与功能,都很符合「生产力优先」的取向。例如我喜欢的 Obsidian、LocalSend 和 Chromium,以及内置的剪贴板管理功能。
此外,系统还提供了许多候选安装项,用户可以通过安装菜单快速获取。
整个系统主要围绕键盘操作展开。重视生产力的用户,应该会喜欢这种以键盘为中心的操作方式。
按下
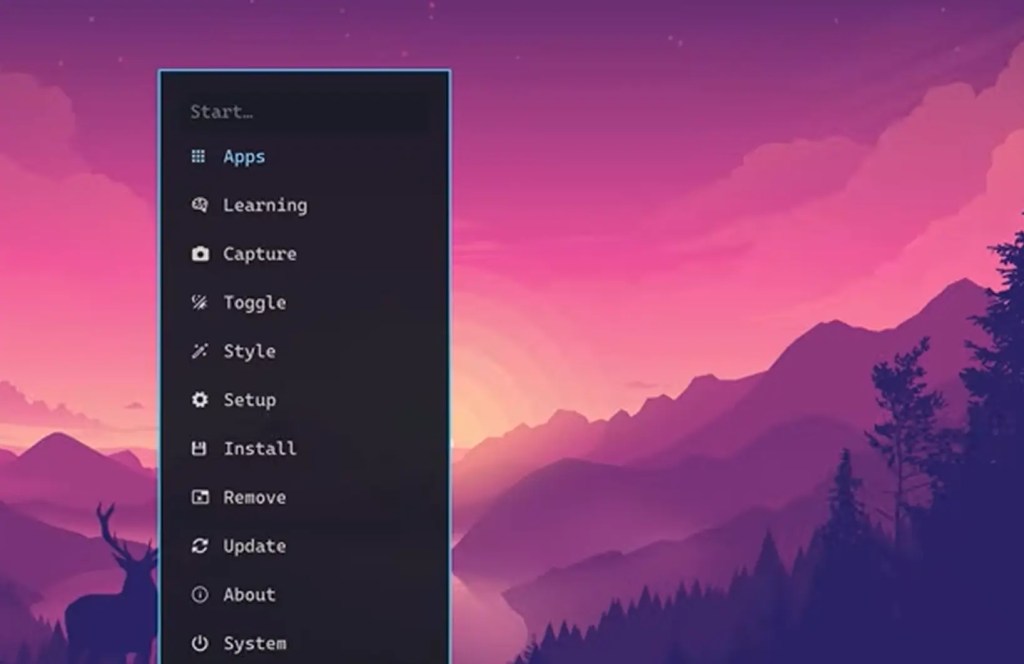
Super + Space就能打开统一菜单,其作用相当于 Windows 的「开始」菜单。我真希望 Windows 能在这方面好好学一下。打开菜单后,用户可以直接用键盘进行筛选,并执行相应的项目。干净利落!
一个由 AI Agent 引导的操作系统?
我要单独谈谈这件事。
发展到目前这个版本,Omarchy 已经开始把 AI Agent 当成系统中的「一等公民」。
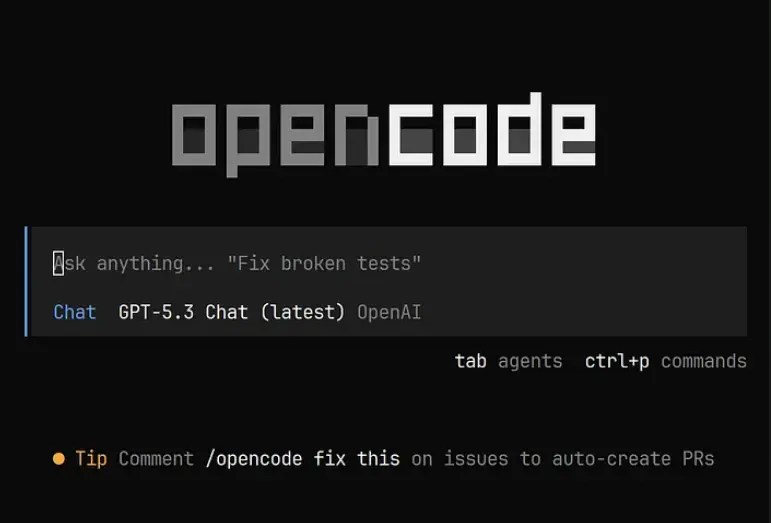
Claude Code、Codex、OpenCode、Gemini CLI 等主流 Agent 都可以直接调用。用户还可以配置默认 Agent 和模型提供商,通过快捷键随时启动,甚至可以让 Agent 带着具体任务直接进入工作环境。
有意思的是,AI 与操作系统的集成并不只是为了陪我们聊天,而是为了直接解决问题。
Omarchy 提供了专门的 Agent Skill,让 Agent 能够理解这套系统的结构。它可以修改 Hyprland 配置、调整桌面组件、制作主题,甚至参与排查系统崩溃等问题。
例如,我想为笔记本触摸板配置一套通过滑动手势切换虚拟桌面的操作方式,只要把意图告诉 Agent 即可。我使用的是 OpenCode,连接的模型是 GPT 5.6 Luna。很快就搞定了。
我知道,如果没有 AI 辅助,我肯定得上网查询应该修改哪个配置文件、具体改动哪几行,然后再亲自打开文件进行调整。只是想想这些,就觉得麻烦。
现在,我只要说一句话就能完成。
我不是资深 Linux 用户,记不住那么多操作与配置。我也不认为自己有必要记住这些细节,只要让知道如何处理的人或程序去做就可以了。
当然,这种自然语言式的命令行交互可能有些激进。因此,在执行关键操作前,大家仍然应该做好备份与回滚的准备。
Omarchy 目前还远远称不上成熟的「Agentic OS」,但它已经相当具体地展示了一种可能性:未来操作系统的易用性,未必来自把底层的一切全部隐藏起来,也可能来自让 AI 帮助普通用户驾驭一个原本完全开放的复杂系统。
实际使用中遇到的一些问题
虽然我很喜欢 Omarchy 的理念,但不得不说,我在实际使用中还是遇到了一些恼人的问题。
我给两台旧笔记本电脑安装了 Omarchy,其中一台遇到了比较严重的兼容性问题:
- 无线网卡无法正常识别。
- 从休眠状态恢复时,系统偶尔会卡死,只能强制关机。
- 一些应用在启动后会崩溃。
- 连接外部显示器时,有时会出现画面闪烁或跳动。
安装 Omarchy 时,需要通过 USB 引导启动,并在 BIOS 中关闭 Secure Boot。
面对不同型号的笔记本电脑,我一开始甚至不知道该如何在开机时进入 BIOS。对新手来说,可能第一步就会被卡住。
这也解释了为什么 Windows 和 macOS 更容易被普通用户接受。
Windows 背后有长期发展形成的 PC 兼容标准和成熟机制。各家供应商也会按照相应标准生产硬件,并由操作系统进行统一适配。
Windows 在早期同样存在大量兼容性问题,只是这些问题后来逐步得到了改善。
至于 macOS,其软硬件均由苹果统一掌控,就连 CPU 芯片也由苹果自行设计,因此不必适配数量庞大的第三方硬件组合。
而 Omarchy 本质上仍然是 Linux,需要面对数量庞大且高度碎片化的硬件设备。理论上,Linux 可能遇到的兼容性问题,它同样都可能遇到。
除非 Omarchy 将来推出自己的计算机硬件,以保证经过「主厨挑选」的软硬件能够严格兼容。
说不定以后真的会有。我觉得,如果 Omarchy 真能推出自己的硬件,其吸引力或许会超过基于 ChromeOS 的 Chromebook。
最后
Omarchy 虽然是「主厨精选」,但也保留了让用户自己动手的权利。
传统 Linux 经常先把所有选择摆出来,让用户自行组装。Omarchy 则让用户先沿着一条主路前进,等真正遇到不合适的地方时再作调整。
不让用户把过多注意力投入「折腾」,本身就很有价值。
有时,工具越灵活,我们就越容易把时间花在「设计、配置一套理想工作流」上,而不是去完成真正重要的工作。
安装一堆 Obsidian 插件,不等于留下了更多有价值的笔记;做出一个漂亮的 Notion 仪表盘,不等于项目推进得更快;把 Raycast 配置成瑞士军刀,也不代表每天真的会用到那些命令。
我越来越觉得,生产力更依赖几条稳定、重复,并且几乎不需要思考的路径。
不必过度关注别人所谓的「终极生产力系统」或「知识库体系」。那些东西很可能成为「注意力杀手」,把我们的注意力引向枝微末节,反而让我们忘记真正的目的。
一个固定的收件箱、一套够用的模板、几个已经形成肌肉记忆的快捷键,可能比一个拥有无限可能与无限选择的系统更有效。
在我看来,Omarchy 正是这种理念的一次优秀实践。
手册来了
之前说的我会准备了一份 Omarchy 的 上手指南,现在可以放出了。
免费的,但是给真实需要的小伙伴们,需要订阅本博客,才能免费下载。 链接如下。【免费教程】Omarchy 入门指南(订阅读者专属 PDF)
之前准备手册前,给了下面的调查,继续长期有效。我会不定期来看看。
-
Google Sheets 恐怕不是简单的「在线表格」了:Smart Fill、AI 公式函数,以及最新的 Sheets Canvas
我对 Google Sheets 最早的印象是「在线版 Excel」。随着 Excel 逐渐显得原地踏步,后来我发现 Sheets 甚至可以对标早期的 Airtable,比如生成表单(Forms)等功能。
再后来,我发现 Google 作为主流的 AI 应用玩家之一,非常擅长把 AI 落地到具体的工作场景中。像 Gmail、Docs、Sheets 都是极佳的切入点。目前,放眼整个办公 SaaS 领域,除了微软,其他竞争者差距依然明显。偶尔有些挑战者,像 Notion 也在跃跃欲试;又比如 Grammarly 收购了 Superhuman 和 Coda 试图打造 AI 集成办公环境,但手上的底牌终究不如 Google 雄厚。
我们就来看看,在 AI 加持下的 Sheets 正在走向何方。
过去几年,只要哪个产品宣布接入 AI,大家的第一反应通常是:它是不是又在右边塞了一个聊天框?Google 也未能免俗,早早给 Sheets 安排了一个 Gemini 侧边栏(微软则是 Copilot)。
恕我直言,如果只是生硬地塞进一个聊天框,难免有偷懒之嫌。只有深度融入业务流程的 AI,才是优秀的集成方案。这也是为什么 Google Sheets 最近的一系列变化,非常值得单独聊聊。
现在的 Sheets,既有 Smart Fill 这类自动发现规律的传统智能特性,也有可以直接写进单元格的
=AI()函数;既能通过 Gemini 侧边栏用自然语言创建、修改和分析整张表格,最近还在小范围测试 Sheets Canvas,让同一份表格数据直接生成看板(Kanban)、仪表盘(Dashboard)、日历(Calendar)以及其他具备交互能力的小应用。如果把这些更新串联起来看,Google 显然不仅是给 Sheets 简单粗暴地加几个 AI 按钮而已。随着 Sheets Canvas 的亮相,表格甚至不再只是一个单纯存放数据、编写公式的地方。它正在演变成一个以数据为底座、以自然语言为交互、能随需即时生成界面的轻量工作台。
这究竟是如何一步步实现的?
AI 函数

真正让生成式 AI 进入表格细胞(单元格)内部的,是
=AI()(亦可写作=Gemini())。早在生成式 AI 刚落地时,这曾是一个非常抓人眼球的功能:用自然语言描述需求,让系统自动执行。当时甚至有创业团队仅凭这一特性就大做文章,扬言要颠覆在线表格。如今回看,这不过是在线表格的一个基础 AI 补丁罢了;如果仅以此作为「颠覆性产品」,未免有些幼稚。
例如,在一张客户反馈表里,A2 单元格保存了用户留言,我们可以在 B2 输入:
=AI("把这条反馈概括成不超过 20 个汉字", A2)也可以继续增加几列:
=AI("判断情绪,只返回正面、中性或负面", A2)AI 函数不仅能生成文本、总结内容、归类信息、判断情绪,还能借助 Google Search 补充实时公开信息。比方说,在某一列写上人名,AI 就可以在相邻列搜索并自动生成人物的背景概要。
Spreadsheet 原本是一个严格的确定性计算环境。而 AI 函数将自然语言封装成了大家所熟悉的单元格引用方式,上下文引用直接对应其他单元格,逻辑非常清晰直观。
Fill with Gemini
AI 函数只是第一步。很多人第一次看到 Fill with Gemini 时,会以为 Google 又推出了一套全新的表格 AI。其实,它更像是 Smart Fill(智能填充) 与 AI 函数 的结合体。
Fill with Gemini 主要有两种使用方式:
- 拖拽填充:如果某一列已经填好了至少一个单元格,我们可以从全新的拖拽手柄向下填充。Gemini 会结合整表上下文和已有结果,为后续每一行推导并生成内容。
- 选区生成:选中一片空白区域,直接描述希望填入什么内容。可以交由 AI 自行判断规律,也可以输入一段明确的 Prompt。
这两种方式切中并解决了 AI 函数最大的门槛:绝大多数普通用户根本不想学习新语法,甚至压根不想去理解「公式」这个概念。
用户最熟悉、最肌肉记忆的操作,就是选中、拖拽和填充。Google 巧妙地把生成式 AI 藏进了这些既有动作中。我们不再需要费心去记
=AI(),也不必繁琐地复制函数,只需像过去一样随手一拖,Sheets 就从「机械复制相同值/简单序列递增」升级为「理解这一列的任务目标,并为每一行生成贴切的结果」。它极其适合处理那些 大量重复、以文本为主、且每一行内容均有细微差异 的任务。
- AI 函数:显式声明,适合在单元格中精确定义任务与引用范围;
- Fill with Gemini:隐式操作,把 AI 函数封装成更符合直觉的拖拽与选区填充。
越依赖复杂语义判定的任务,越适合写 AI 函数;而追求高效率的批量处理,Fill with Gemini 则更直接快捷。
Gemini 对话

AI 对话框终究也是必不可少的。
如果说 AI 函数是在微观的单元格里派发具体任务,那么右侧的 Gemini 对话面板处理的就是宏观的整张表格。
早期的侧边栏更像一个「被动回答者」。我们可以向它提问:“这张表体现了什么趋势?”“业绩最好的是哪个部门、发生在什么时候?”而现在,它越来越像一个坐在你身边的「全能操作员」了。
目前,Gemini 已经能够直接建表、写公式、分析数据、生成可视化图表,还能主动添加条件格式、创建数据透视表、执行排序与筛选、查找替换文本,以及进行插入、编辑、删除和冻结行列等操作。
在 AI Agent 浪潮下,它甚至开始接管跨场景的复合任务。例如:用户只需用自然语言提出诉求,Gemini 可以从 Gmail、Google Drive、Chat 乃至互联网中检索相关信息,先梳理出一份执行计划交由用户确认,随后全自动建立起包含格式、公式、透视表和图表的完整报表。
短期内,我更倾向于将它定位为一个手脚麻利的初级操作员,而非资深的数据架构专家。但随着时间推移,它大概率会愈发成熟,甚至能够自主设计并操作完整的业务流。
Sheets Canvas
前面提到的功能,无论体验多么智能,用户最终面对的依旧是一张传统的电子表格(Spreadsheet)。
而 Sheets Canvas 这个目前仅在小范围测试的功能,才真正称得上是令人眼前一亮的「重头戏」。
Google 在公布 Sheets Canvas 时,将其定义为建立在表格数据之上的**「交互式小程序」(interactive mini-app)**。
现在,AI 可以根据一个 Sheet 工作表和一句自然语言指令,快速生成 Dashboard(仪表盘)、Heat map(热力图)、Kanban(看板)、Gallery(画廊)、Calendar(日历)乃至更自由的自定义交互布局。
虽然我目前尚未拿到该功能的内测资格,未能亲自实操,但仅从公开展示的能力来看,就已经足够震撼。

简单来说:Canvas 充当了读写交互界面,而底层 Sheets 则是数据源。
我们在 Kanban 里拖拽移动一张任务卡,原表中的状态字段会同步变更;在日历里修改日期、新增记录或删除项目,改动会直接写回底层表格。反之,一旦原始数据发生变动,Canvas 界面也会即时响应刷新。
假设一个小团队使用 Sheets 管理内容排期,表内包含选题、负责人、发布渠道、状态、发布日期和优先级。过去,团队可能会为了看板特意搬去 Trello,为了日历视图搬去 Notion,为了看数据汇总又得接入第三方 BI。而现在,只需对 Gemini 提一条要求:
“根据 Status 列建立一个内容看板,卡片显示标题、负责人、渠道、发布日期和优先级;逾期项目用醒目颜色标出,并允许编辑者拖动卡片改变状态。”
Gemini 便会在原始数据之上直接搭建起一层全新的可视化操作层。数据依然安稳地躺在 Sheet 表格里,但并非所有团队成员都需要面对密密麻麻的行列,业务人员只需在直观的看板上查看进度、拖拽更新状态即可。
这一步标志着 Sheets 开始跨越传统 Spreadsheet 的边界,蜕变为一个极轻量化的无代码(No-Code)平台,让懂业务、会用表格的人,能够零代码生成供整个团队协同的微型业务应用。
未来图景的一瞥与边界
与当下热门的 Vibe Coding 类似,「快速生成一个 Demo」和「长期维护一套生产系统」有着本质区别。
一套严谨的企业级业务系统,需要稳定的字段设计、主键约束、关系引用、细粒度权限管控、自动化流程、操作审计、测试及版本发布机制。Sheets Canvas 目前更擅长基于一张规整的明细表,快速搭建一个好用的操作界面,其本质仍是轻量级应用。至于企业的关键核心业务流程,现阶段显然还不适合直接托管于其上。
展望未来,我毫不怀疑 AI 具备整合复杂数据、构建复杂流程并提升系统可维护性的潜力。但这仍需要时间演进。
当看到 AI 函数、Gemini 自动化操作以及 Sheets Canvas 展现出的能力时,很多人容易产生一种错觉:以后我们是不是完全不需要学公式和表格操作了?
这恰如大家在讨论 Vibe Coding 时的疑问:以后是不是完全不需要学编程了?
答案是否定的。只要一个任务存在明确的业务逻辑与计算规则,就应该优先交由普通公式或确定性机制去处理。
例如:税额计算、日期差、库存结余、主键查找匹配等。这些计算必须保证确定性与绝对准确,绝不能因为模型重新生成一次就得出不一样的结果。AI 目前更适合处理难以用规则穷尽、但人类凭语境能轻松判断的任务;而对于严密的流程设计与确定性计算,AI 仍不适合完全放手让其自主决策。
因此,更合理的落地姿态并非让 AI 大包大揽接管整张表,而是将确定性能力与生成式能力进行分层:
- 底层:原始数据与核心计算留给传统表格机制(保证数据精准性);
- 中层:AI 负责难以规则化的非结构化文本处理,辅助列记录数据来源与人工核验状态;
- 顶层:Canvas 作为友好的展示与交互界面。
未来,AI 或许会承担起调度和编排确定性函数与 API 的角色,但最终的校验把关与责任归属,依然需要人类来掌控。
结语
据我观察,许多小团队生命周期里的第一个业务系统,往往就是一张本地 Excel 表格或在线 Google Sheets。
客户名单、项目看板、内容排期、库存台账、预算追踪,通常都是从区区几列字段起步的。随着数据膨胀、业务复杂化,团队才不得不逐步迁移至 Airtable、Notion、Trello、AppSheet,乃至定制开发独立的业务系统。
Google Sheets 如今所发力的方向,正是尽可能延缓这种迁移的发生,它把「搭建轻量业务工具」的门槛压到极低,从而让用户与团队能够更长久地留在 Google 的生态体系之中。
-
【速报】Zotero 10 发布了!老牌的研究工具没有盲目加入AI,而是继续在 「读PDF」 和 「高级搜索」 上加强。
2026 年 8 月 17 日,Zotero 10 正式发布。
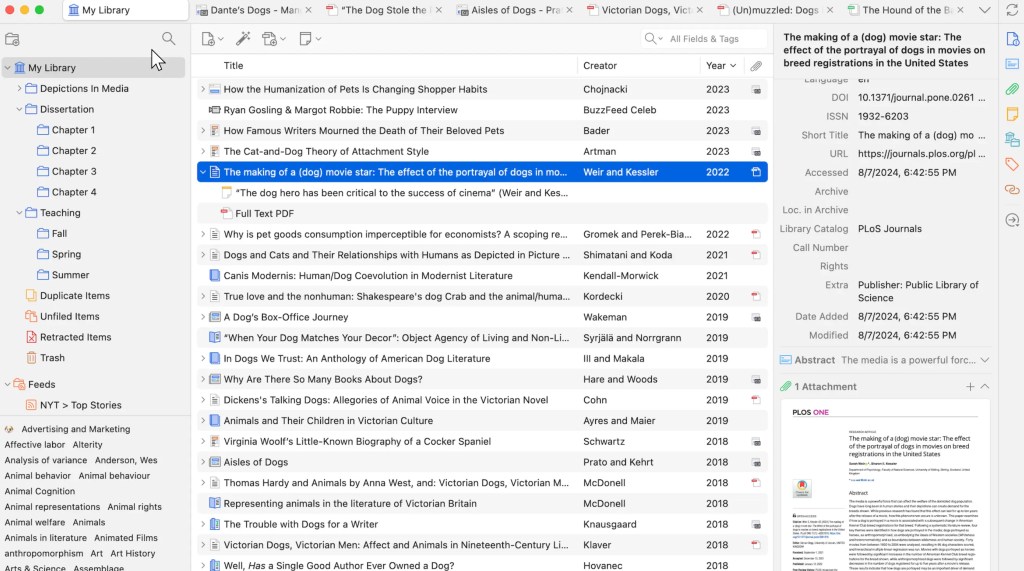
Zotero 10 最显眼的变化是重构了「高级搜索」,并新增多 Collection 选择;此外还带来了批量编辑与撤销,以及能重排 PDF 版面的 Reading Mode。
这次更新挺有意思的,在多数生产力工具都急着加上 AI 对话框讲故事的时候,Zotero 相当克制。它想解决的像是资料库膨胀之后、资深用户才会真正遇到的那些痛点。
当资料库超过几千篇,「收集」就不再是重点
Zotero 是一个开源工具,本地使用完全免费。如果要用官方的同步存储,超出免费额度(目前 300MB)后需要付费订阅,模式和 Obsidian Sync 接近。
Zotero 最初主要用于学术文献管理,很多人后来会把它当成自己的 PDF 资料库。再后来,论文、行业报告、电子书、网页快照、课程资料,甚至扫描件,都被扔了进去。
浏览器里的 Zotero Connector 很方便,看到一篇资料甚至博客,点一下就保存了;如果拖进一个 PDF,它又会尽量识别标题、作者、DOI 等元数据。
收集太容易,反而会制造另一个问题:资料库开始膨胀。
刚开始只有几十条记录时,Collection 就像整齐的书架。到了几千篇以后,同一篇资料可能同时属于一个项目、一个研究主题和一个客户;有些 PDF 做过批注,有些只看过摘要;还有些是十年前导入的,标题和作者字段早就不统一了。
这时候有些工具就会「自作聪明」地端出 AI 分类、AI 摘要、AI 清洗等功能……但 Zotero 没有跟风,而是转头去加强资料库的基础设施。
更高级的「高级搜索」
Zotero 以前当然也有高级搜索,但更像一个独立的小工具。以前的流程是:打开高级搜索窗口,组合条件,查看结果;要把复杂条件长期保留下来,往往还要做成 Saved Search(保存的检索)。麻烦的是,一些跨层级查询需要串联多个 Saved Search 才能实现。
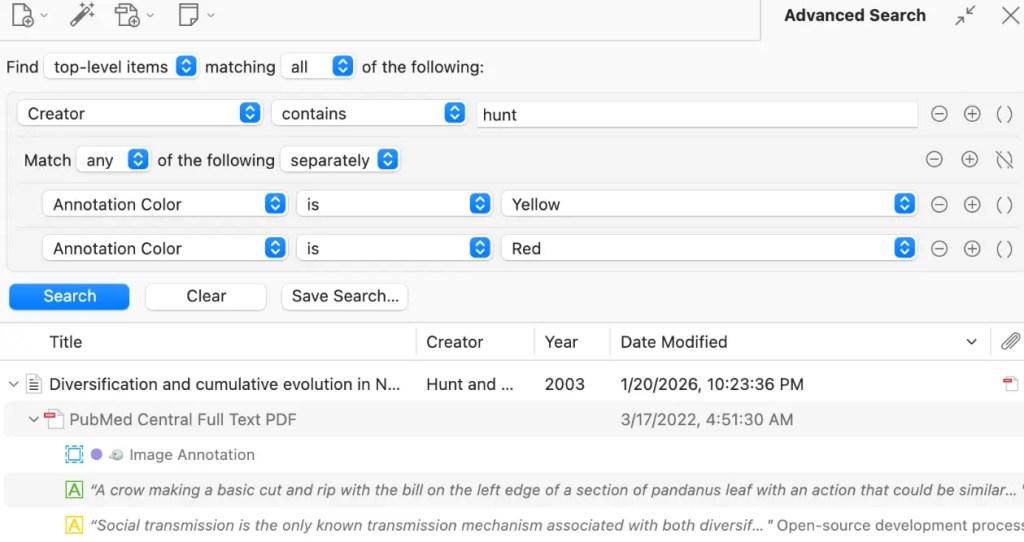
Zotero 10 把高级搜索放回了主窗口。快速搜索栏旁边现在有一个筛选按钮,点开后,条件会直接出现在条目列表上方。它可以过滤当前的 Library(文库)、Collection 或 Saved Search,结果出来以后,也可以马上选择、编辑和整理。
这个位置上的变化看起来不大,实际影响不小。搜索不再是一个打开、查完、关掉的独立窗口,而成了资料库界面里的常驻过滤层。
如果先在快速搜索栏里输入关键词,再点高级搜索,Zotero 还会自动把现有查询转换成对应条件。高级搜索面板在切换 Collection 时不会消失,相当于终于可以「钉住」一组条件,再去不同的资料范围里反复查看。
而且,搜索条件开始理解 Zotero 的层级关系。
一篇论文是顶层条目,下面可能挂着 PDF 附件、笔记和批注。以前想找「作者是某人,而且其 PDF 里有黄色或红色批注的论文」,得先想清楚自己到底是在搜条目、附件还是批注。Zotero 10 可以先指定结果层级,例如顶层条目或批注,再组合嵌套条件,Zotero 会自动把不同层级的条件映射到目标结果上。
换句话说,我们可以这样找:
- 作者是某人,并且下面存在黄色或红色批注的论文;
- 带有「待引用」标签,而且附件正文中出现某个术语的顶层条目;
- 某几个项目 Collection 中,最近读过、至少有一条笔记的资料;
- 某位作者名下的所有批注(而不必先找论文,再逐篇展开附件)。
高级搜索还增加了批注颜色、批注类型、笔记数量,以及「为空」「不为空」等条件。对于长期积累的 Library,这些条件不是炫技,而是让过去留下的阅读痕迹重新变得可用。
另外,跨语言、跨排版形式的搜索也很实用:
cafe能匹配café,纯文本的H2O也能匹配带下标排版的H₂O。这些功能很专业,门槛也确实不低。对于积累不多、并非专职做研究的用户,可能一时感受不到价值,但这大概也正是 Zotero 长期被当作专业研究工具的原因。
多 Collection 选择,改变的其实是整理思路
Zotero 的 Collection 并不是真正的磁盘文件夹。同一条资料可以同时放进多个 Collection,不会复制出多个条目。这更像播放列表,而不是传统意义上像文件夹目录树那样。
但由于过去一次只能进入一个 Collection(传统意义),很多人还是会下意识地搭出一棵越来越深的目录树:领域下面分项目,项目下面分主题,主题下面再分「已读」和「未读」,层层嵌套,越理越乱。
Zotero 10 终于支持在左侧栏同时选择多个 Collection、Saved Search,甚至多个 Library,并在中间列表里查看合并结果。
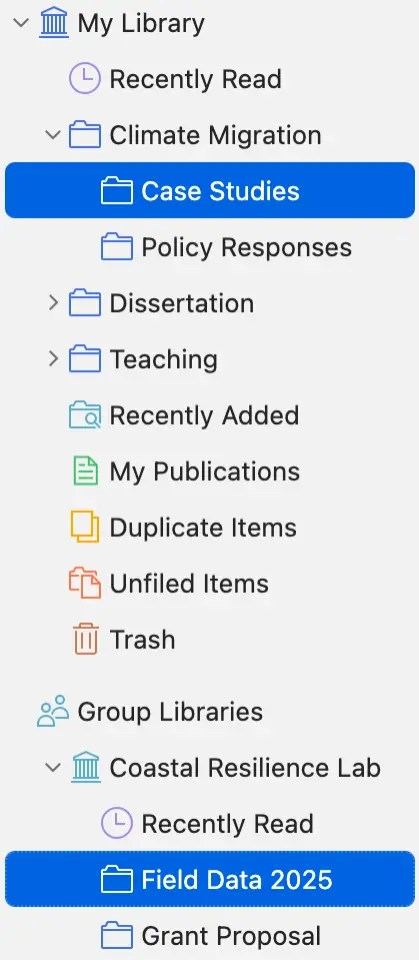
例如,我们可以同时选择「AI Agent」「知识管理」和某个正在进行的客户项目,再用顶部的高级搜索面板过滤:附件正文包含
local-first,而且存在黄色批注。以前这种查询往往迫使我们移动条目、临时加标签,或者串联多个 Saved Search;现在不必为了一次查询去重构资料库。我觉得,这会让 Collection 回到它更适合的位置:用来表达资料属于哪些项目或场景,而不是强迫每篇资料只能住在唯一的抽屉里。有点像「标签」,但我觉得「播放列表」这个比喻更合适。
Reading Mode:把论文重排成能读的样子
除了搜索,这次更新的另一个亮点是 Reading Mode。
Zotero 10 为 PDF 增加了 Reading Mode。它会分析文档结构,把正文重排成单栏、可连续滚动的阅读视图,去掉页眉、页脚和原始分栏,还可以调整字体、字号和行距。碰到无法转换成文本的图片、表格和图形,则保留原始 PDF 的渲染结果,避免内容直接消失。
提取后,我们仍然可以在 Reading Mode 里高亮、加下划线和写笔记,这些批注会同时出现在普通 PDF 视图中;在两个视图之间切换时,阅读位置也会保留。不过区域截图、图片和手写类批注目前仍然只能在 PDF 视图里显示。我觉得,如果能同步呈现在侧边栏,体验会更好。
Read Aloud:略有加强
Read Aloud 是 Zotero 9 加入的朗读功能。Zotero 10 没有停留在增加几个新音色这种层面上,而是改进了朗读背后的文本解析。目前朗读仅在桌面端支持。
过去的 PDF 朗读经常会把页眉、页脚、文内引用、表格单元格、坐标轴和公式全部念出来,双栏或跨页的段落也可能被截断。Zotero 10 的文档分析系统会尽量识别这些结构,跳过文内引用、页眉页脚、表格、图形和公式,让跨栏、跨页的段落能连续读下去,听起来更连贯自然。
朗读时默认按句子高亮,而不是一次亮起整段;也新增了「上一句/下一句」按钮。对于长文档,开始朗读前的等待时间也缩短了。
需要说明的是,不注册账号也能使用朗读,但要用上高质量的 Zotero Voices,必须联网并登录 Zotero 账号;离线时,默认调用操作系统自带的语音。更高质量的语音需要把文本上传到云端生成。因此,如果材料涉及未发表成果、商业机密或个人隐私,不建议使用在线音色。
Zotero 10 没有 AI?
Zotero 生态里其实并不缺 AI。像我这样极力推崇「工具链」思维的人,第一反应就是:根本不需要 Zotero 自己集成 AI,只要让 AI 能访问 Zotero 就够了。
Zotero 确实有开放 API,也有插件机制,再配合 MCP,完全可以把 AI 能力延伸到 Zotero 内部。从这个角度看,Zotero 10 的高级搜索、全文索引、Reading Mode 和文档分析系统,其实也在为未来的 AI 工作流打地基。只不过它没有急着把最终界面做成一个对话框,这点我很欣赏。
最后
Zotero 10 并不是一次让人眼花缭乱的更新。
Zotero 本来就不是那种被吹得天花乱坠的「下一代 AI 研究工具」,也不是风投眼中颠覆性的魔法产品,更不是社交平台上被反复转发的「效率图腾」。
Zotero 一直就是一个看似枯燥、实则强大的纯粹工具。对一个积累了几千篇资料的研究者来说,这次更新带来的是真正的效率提升。
当然,研究工具的下一步肯定会有 AI 接入。我们会让 AI 帮忙找论文、比较观点、解释公式、整理批注,甚至参与部分创作。但我觉得这更像一个分工问题:不必把所有能力都塞进一个「大而全」的应用里,各司其职、让用户自由组合,才是更好的答案。
-
Reflect Open:当云笔记主动拆掉自己的数据围墙,回到「本地优先」
我之前的文章介绍了很多 PKM 工具,其中一大类就是「云笔记」。但我一直推崇「本地优先」,希望大家在条件许可的情况下,将重要的笔记和文档存储在本地,或自己信任的云存储中,不要被 App 自带的云服务「绑架」。
从商业角度看,用户将越来越多的笔记存入 App 的云端,由厂商负责保存、同步和搜索。数据越积越多,迁移成本也越来越高。只要服务保持稳定,用户就会一直订阅下去,难以脱身。
所以,2026 年 7 月,Reflect 发布 Reflect Open 时,我觉得这件事比市面上又多出「一款本地 Markdown 笔记工具」有意思多了。
Reflect 原本卖的就是一款云笔记订阅服务。它有自己的笔记格式、同步引擎和云端数据库,也曾把端到端加密作为核心卖点。现在,它却重新造了一个 Reflect:不需要 Reflect 账号,不再依赖 Reflect 的笔记服务器,数据直接保存为本地 Markdown 文件。Mac 版免费,并采用 MIT 许可证开源;AI 也需要用户自己提供模型密钥,也就是 BYOK。
换句话说,Reflect 主动拆掉了过去最像订阅护城河的那部分,从「云端订阅」回到了「本地优先」。
这到底是为什么?
Reflect Open 是一款全新的产品
Reflect Open 并不是在现有的 Reflect App 中增加「本地保存」功能或「离线模式」。
它是一款独立的新应用。旧版云端 Reflect 仍然保留,官方会继续维护并修复问题,现有用户也没有迁移期限;但新的开发重心已经转向 Reflect Open。用户从旧版导入数据时,得到的是一份独立副本,之后两边的修改不会继续同步。
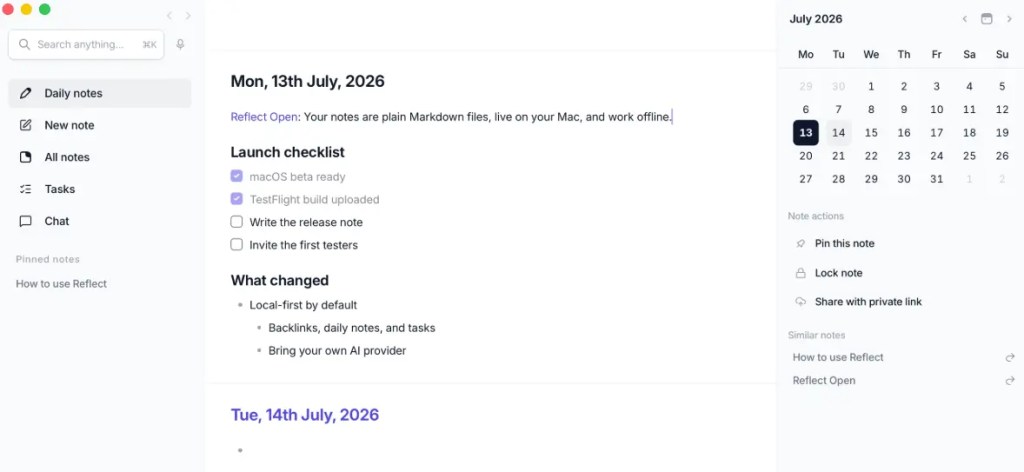
这意味着两套 Reflect 应用将同时存在。
旧版 Reflect 的基础,是私有笔记格式、Reflect 自建的同步引擎和云端服务。笔记在客户端加密后上传,官方此前采用加密存储方案,也接受过第三方安全审计。对普通用户来说,这套方案的好处非常直接:登录账号,多台设备自动同步,后端全部由厂商负责维护。
Reflect Open 的架构思路则与 Obsidian 十分接近。
Reflect 所说的本地资料库,也就是 graph,现在只是一个普通文件夹。在那个时期,将资料库称为 Graph 曾是一种流行做法,意在强调这是一套「链接优先」的笔记系统,其中的一切内容都可以被视为 graph 中的节点。
现在,每日笔记放在
daily/,其他笔记放在notes/,图片和附件放在assets/。Markdown 文本文件才是资料库的主体。我们可以在 Finder 中直接看到笔记,也可以使用其他 Markdown 编辑器进行修改,将整个目录纳入 Git 管理,或者让脚本和 AI Agent 直接读写。即使 Reflect Open 有一天停止维护,文件也不会跟着失效。
这就是 Reflect Open 最大胆的地方:它不再要求用户必须经过 Reflect,才能接触自己的知识库。
云端数据库,为什么会在 AI 时代显得沉重
以前,云端数据库通常意味着更强的产品能力。
开发团队可以自行决定文档结构,精准控制实时同步、冲突处理、权限、版本历史和离线状态。用户不需要看到磁盘上凌乱的文件,也不需要理解 Git 是什么。Notion、Craft、Roam 和旧版 Reflect 都在不同程度上受益于这条路线。
但在 AI Agent 出现之后,衡量一套笔记架构的标准发生了变化。
过去,我们主要要求 App 自己能够读写笔记。现在,我们还希望 Claude Code、Codex 或其他 Agent 能够搜索资料库、批量整理标签、修改文章、生成项目摘要,并将结果直接写回资料库。

面对普通的 Markdown 文件,AI 早已知道该怎么办。它可以遍历目录、进行全文搜索、比较版本、修改指定段落,也可以借助 Git 查看每一次变化。即使不使用 Reflect Open 自带的 AI,用户仍然可以将同一个文件夹交给其他工具。
面对 App 的云端数据库,事情就复杂得多。对外部工具而言,它往往像一座封闭的信息堡垒。
为了实现数据互通,每个 App 都需要先开发 API,再设计授权范围,维护 SDK、MCP 接口或数据导出机制,还要明确哪些字段允许读取、哪些操作允许写回。
如果接口不完整,AI 只能看到厂商愿意开放的一小部分能力;如果必须先将整套资料上传至厂商服务器,再由厂商调用模型,隐私、成本和模型选择也就全部被绑在了一起。
我相信,在过去 20 年里,云端存储、自有格式和同步引擎在各自出现的时期,都是合理甚至先进的设计。但它们也带来了大量复杂性,使产品越来越难以演进,信息则变得越来越封闭和孤立。
过去,笔记软件比的是谁能把数据封装得更好,让用户在享受便利的同时越来越难以迁移;现在,如果数据无法顺畅地开放给 AI,就很可能被更适应 AI 时代的替代品取代。
BYOK AI
Reflect Open 自带 AI Chat,可以跨笔记提问并返回引用,也支持选中文本后进行改写、总结和翻译,还可以运行用户保存的提示词。
可选的语义搜索功能会在本机生成嵌入向量(Embedding),使用随应用提供的本地模型,索引也可以随时重建。
不过,Reflect 并没有将云端 AI 作为一项打包服务提供给用户。
用户需要自己填写 OpenAI、Anthropic、Google 或 OpenRouter 的 API 密钥,密钥保存在操作系统的钥匙串中。请求会由 App 直接发送给相应的模型提供商,Reflect 不做代理,模型调用费用也由用户自己承担。用户还需要在不同设备上分别设置密钥。 这也是最近比较流行的 一种方式,我们上次提到的 Raycast 工具 也在今年推出了 BYOK AI 接口。
Raycast 的 BYOK 宣传图 比较巧妙的是,用户可以为本地 Reflect 笔记设置「私有属性」,防止相关内容被 AI 或其他需要读取笔记的外部服务获取。
所以,「本地优先」不等于「所有 AI 都在本地运行」,BYOK 也不意味着数据一定不会离开电脑。
数据只是默认留在本地;当用户启用某项外部服务时,内容会直接流向用户选择的服务商,而不是先经过 Reflect。
同步和加密,从产品能力变成了用户选择
旧版 Reflect 的端到端加密是产品架构的一部分,Reflect Open 则不再额外提供自有的端到端加密层。
Mac 上的资料库可以放在任意本地文件夹中。如果要在 Mac、iPhone 和 iPad 之间同步,最简单的方法是将其放入 iCloud Drive;用户也可以连接 GitHub,或使用由自己控制的其他 Git 远程仓库。
Git 的优势在于能够保留完整的版本记录,但私密仓库、密钥、权限和备份是否设置妥当,都需要用户自己负责。
用户拥有了更多选择,也必须为这些选择承担相应的责任。
为什么不直接用 Obsidian
看到本地 Markdown、双向链接、日记、标签、附件和 Git,大多数人的第一反应恐怕都是:这不就是另一个 Obsidian 吗?
除了 Obsidian(下图),现在也已经出现了不少采用「本地 Markdown + BYOK AI」模式的工具,我此前介绍过其中一些。
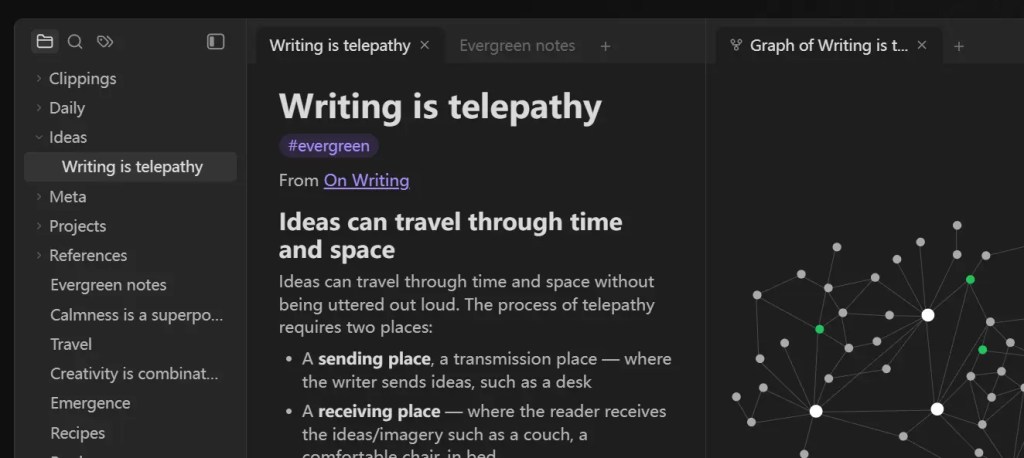
Obsidian 已经拥有成熟的跨平台应用、庞大的插件生态和多年的用户积累。Reflect Open 目前还没有 Windows 和 Android 版本,Mac 是主要平台,iPhone 和 iPad 版本仍处于有限范围的 TestFlight 测试阶段。
Reflect Open 的优势并不是功能更多,而是更加克制。
它试图保留原版 Reflect 最受欢迎的部分:打开就是今日日记、快速记录、反向链接、键盘操作,以及不需要用户事先搭建一套复杂系统的界面。
对于不喜欢折腾插件和主题的人来说,这种具有鲜明设计取向的本地 Markdown App,仍然有其价值。
尤其对于原本就在使用 Reflect 或其他云端双链笔记工具的用户来说,Reflect Open 的界面会显得更加亲切。用户可以较为轻松地将原有习惯迁移到本地笔记环境中,而不需要重新学习一套复杂的工作方式。
我个人认为 Reflect Open 值得持续观察,但它恐怕在很长一段时间内都不会撼动 Obsidian 的地位。
它今天之所以值得一谈,是因为它代表了一种从「云端订阅」回归「本地优先」的趋势。Reflect 愿意在开放的数据基础上,继续打磨一种更精致、更具自身特色的产品体验,这是一次值得鼓励的尝试。
这一切,都是为了让用户真正拥有更多选择。
最后
风向可能正在改变。
以前,App 通过「云端订阅」锁定用户数据,从而掌握主动权。但在 AI 时代,当 AI 需要直接读取和修改知识库时,这些「云端数据」可能从资产变成摩擦。
Reflect Open 给出了一个新的表态:回归本地优先,为 AI 提供更顺畅的数据接口。
需要注意的是,在多人实时协作、精细权限管理、结构化业务流程和强一致性要求较高的场景中,云端数据库仍然比一组本地 Markdown 文件更合适。
Notion 这样的产品,几乎不可能只依靠文件夹完成团队协作。企业知识库也不能将访问控制完全交给 Git 或本地共享文件夹。
这并不是一个「本地文件必然战胜云端数据库」的故事。
当数据主要属于一个人,而 AI、脚本和多个编辑器都需要访问它时,私有格式为厂商带来的用户锁定价值,可能会越来越难以抵消它造成的接入成本。
用户不再只问「这款 App 能做什么」,还会问:
「如果我不再使用这款 App,我的资料还能做什么?」
我很认同 Reflect 选择的这个方向,但现在还不会急着宣布它已经成功,因为它的商业模式仍不明朗。原本依靠云存储获得的订阅收入(每月10 美金),未来要从哪里补回来?
毕竟,拆掉一堵数据围墙也许不难;但在没有围墙之后,继续建造一座让人愿意长久居住的房子,或许还要设法从中收租,这才是 Reflect Open 接下来真正困难的部分。
-
当会议机器人消失:Wispr Notetaker 与「隐形转录」
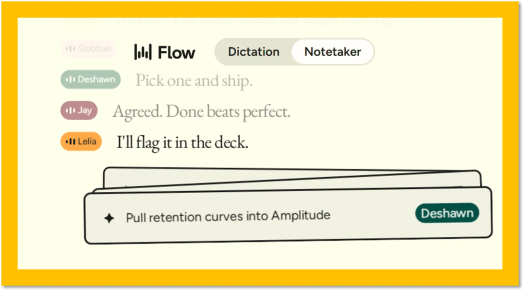
自从 AI 会议转录产品在前两年迅速走红以来,我们参加远程会议时,经常会看到一个陌生的「助手」提前坐在会议室里。
这个「助手」不开摄像头,也不说话,只是安静地旁听,经常出现在 Zoom、Google Meet、Slack 或 Microsoft Teams 中。大家都知道,它就是一个 bot——会议转录机器人。
会议转录机器人一开始只能将语音转换成文字,后来逐渐可以区分说话者、利用 AI 总结和整理内容,甚至生成下一步的行动提纲。显然,大家已经被无尽的会议折磨太久了,因此这类 AI 转录机器人一直是热门应用。
所以,当 Wispr 推出 Wispr Flow Notetaker 时,大家对此似乎已经失去了新鲜感。
但是等等,Wispr 表示:会议转录可以继续,却不再需要派机器人加入会议。
Wispr 就是那家做语音输入工具的公司。有些人可能尝试过 Wispr Flow。它刚推出时或许让人觉得很惊艳,但还不到一年,市面上就已经出现了各种 AI 语音输入替代品,其中既有开源版本,也有不少工具类 App 自带语音输入功能,例如 Todoist(下图)。

于是,Wispr 这次决定做些不一样的尝试。
它新推出的 Notetaker 直接运行在用户设备上,捕获麦克风输入和系统播放的会议音频。无论使用 Zoom、Meet、Teams,还是 Slack Huddle,即使临时开始一场没有写进日历的通话,它也可以提供实时转录,并在会议结束后生成摘要,整理会议决定和后续事项。
简单来说,就是:
录音 + 转录 + 整理
至少现在,不会再有一个陌生的机器人突然加入会场了。
但问题也恰恰出在这里。
以前那个显眼的机器人虽然很烦,却也是一种非常有效的提醒:
房间里还有一套系统正在转录会议。
现在,机器人消失了,记录行为却没有消失,甚至可能变成秘密转录。
Wispr 改变的是音频捕获入口
Wispr Flow 原本是一款语音输入工具。Notetaker 现在把这套能力从「我说一句,它写一句」扩展到了多人会议场景。
Notetaker 会在会议中提供实时转录。会议结束后,它还会结合上下文重新处理整段对话。
它会利用 Flow 的个人词典识别公司简称、产品名称和行业术语,也会读取日历邀请中的姓名,降低行动事项被分配给错误对象的概率。
这其实是 Wispr 一直在打磨的能力。
它不甘心只做一款普通的语音转录工具。Flow 会获取用户的个性化信息,包括过去常说的词汇组合、名称和语气。总之,它会获取一切有助于提高后续识别准确率的上下文信息。
这会形成一道很强的壁垒。一旦成型,其他语音输入工具就很难替代它。
毕竟,你怎么会放弃一个对你了如指掌的秘书,转而去找一个凡事都要从头教起的陌生实习生呢?
除了实时会议,用户或许还可以用它处理其他录音,例如 AI 时代之前留下的传统会议录音或电话录音。
此外,Notetaker 还会按主题整理讨论内容,提取会议决定、时间点和负责人。我们还可以检索过往会议,进行跨会议提问,或者通过 MCP 把会议内容交给 Claude、ChatGPT 及其他 AI 工具继续处理。
这样看来,AI 的确已经大有用武之地。
「在设备上捕获」不等于「完全在本地处理」
如果一款产品写着「runs on your device」,人们很容易将其理解为:数据都在我的电脑里,厂商无法获取会议内容。
目前来看,这可能是一个危险的误解。
我个人认为,在端侧 AI 尚未成熟和普及之前,AI 工具恐怕很难在完全不上传业务资料的情况下完成分析。AI 模型仍然运行在云端,可能只有录音或音频捕获过程发生在本地。
Wispr 明确选择的只是设备端音频捕获。当前版本的 Notetaker 必须开启 Cloud Sync 才能使用。
会议音频会经过加密,并在设备上短期保留。在某些情况下,音频也可能暂时进入云端,用于恢复会议、核验转录结果或排查故障,之后再按照相应设置删除。
逐字稿、摘要、行动事项和其他会议数据,则可能根据账户设置继续保留。
Wispr 也可能调用第三方 AI 服务。其政策称,服务商不得使用这些内容训练模型,相关内容通常会在 30 天内删除,但仍然会受到服务商自身规则及当地法律的约束。
开启 Privacy Mode 并不等于关闭云端存储。Notetaker 目前仍然依赖 Cloud Sync 才能工作。
所以,更准确的说法应该是:
Notetaker 在设备上捕获会议音频,再通过云端同步和 AI 服务完成整套体验。
如果会议中涉及真正敏感的商业秘密,比如大家正在开发一款准备干掉 Wispr Notetaker 的产品,那最好不要让 Notetaker 为你提供转录。
机器人很碍眼,但「碍眼」反而是一种功能
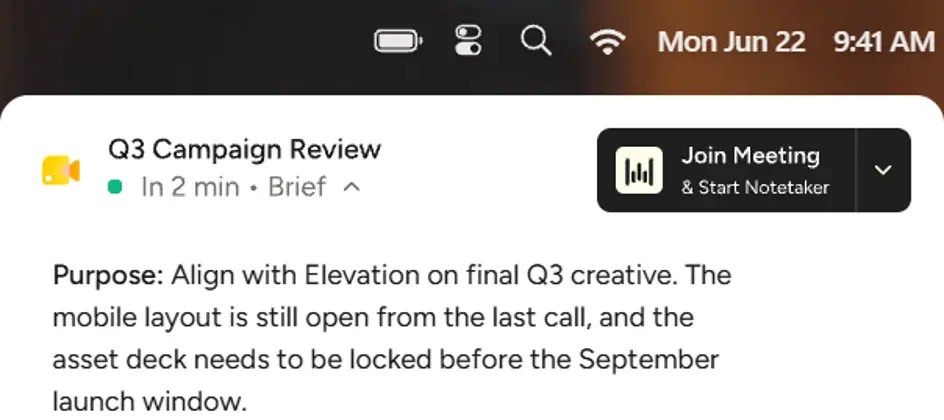
传统的会议机器人会占据一个参会席位,而且所有人都能看见。
出于法律或合规要求,有些产品在录制会议内容时,会明确告知参会者当前会议正在被录制。
这些设计都能让其他人意识到:会议正在被记录。
大家可以询问缘由、拒绝录制,或者直接把机器人移出会议。
Otter 是一款比较知名的 AI 会议记录工具。目前,它仍然会让记录程序以具名访客的身份出现在会议中,并在聊天区发出转录提示。
一般来说,这类产品的典型工作流程也是让机器人加入通话。这当然不等于获得了完整的知情同意,却至少提供了一个明显的标志。
因此,Wispr 也提醒用户:由于 Notetaker 不会以机器人身份加入会议,其他参与者可能收不到自动通知,使用者有责任在会议开始前告知所有人。
当然,我们都知道,这也是一种免责表述。
Granola 和其他类似工具
Wispr 并不是第一家采用无机器人记录方式的产品厂商。
Granola 很早就开始直接从电脑的麦克风和系统音频中捕获会议声音。
根据 Granola 的说明,会议音频仅在实时转录过程中被临时缓存。转录完成后,相关音频会从 Granola 及第三方服务中删除,不会被保存为可以永久回放的录音;逐字稿和笔记则会保存在服务器上,并同时缓存在用户设备中。
所以,Granola 也不是完全在本地运行。
它减少了原始音频被长期保存所带来的暴露风险,但文字资料仍然会进入云端。逐字稿可以被搜索、复制,还可以交由 AI 批量分析,因此未必比录音更加无害。
需要注意的是,许多 App 所说的 Zero Data Retention,通常是指第三方服务商在完成处理后,不再保留相关内容,也不将其用于模型训练。
但这并不代表内容从一开始就不会被保存在云端,也不能完全消除第三方处理会议内容所带来的风险。
所以,真正的差异已经不再是谁能够生成摘要,而是:
- 谁启动了记录;
- 其他参与者能否看见;
- 是否保存原始音频;
- 逐字稿和摘要会保存多久;
- 会议内容还会流向哪些第三方。
这些第三方,一般也就是大大小小的 AI 模型和云服务提供商。
一般团队应该如何使用
我认为,团队不需要一开始就编写几十页的 AI 治理白皮书,但至少应该建立以下几条规则。
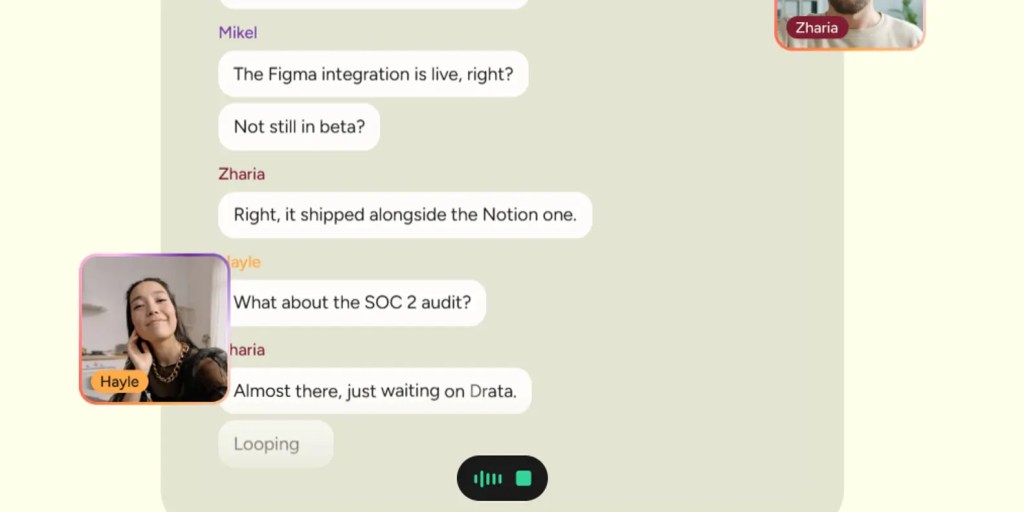
第一,如果允许使用 AI 工具录音,就必须事先告知所有参会者
有没有机器人加入会议,并不是判断是否需要告知的标准。
只要会议内容正在被录音、转录或者交给 AI 分析,参与者就应该知道。
第二,对会议进行分级,不要允许 AI 记录所有会议
普通的项目进度同步、公开信息讨论和常规工作汇报,或许适合使用 AI 工具进行记录。
但涉及商业秘密、人事决策、法律事务、客户隐私和安全事件的会议,则应该更加谨慎,甚至直接禁止使用 AI 转录工具。
第三,制定相关政策,明确数据的保留期限
团队应该明确规定音频、逐字稿和摘要分别保留多久。
如果使用 AI 记录会议只是为了推动下一步行动,那么原始音频完全可以在转录完成后删除;逐字稿可以短期保留,以便核对内容;最终摘要则可以作为项目文档长期归档。
毕竟,有些会议中真正有价值的信息本来就不多,浓缩以后可能还不到一页纸。
最后
我个人很喜欢 Wispr Notetaker 所代表的方向。
过去的会议机器人很可能只是一种过渡形态,是早期受技术限制而采用的方案,没有必要成为 AI 会议记录的永久形态。
不过,不管有没有 AI 机器人,下面这些问题都值得关注:
- 会议内容究竟有没有被录制?
- 数据被送到了哪里?
- 数据由谁处理?
- 数据未来将如何保存?
- 参与者是否知道这一切?
Wispr Notetaker 这类产品接下来的竞争,不应该只是看谁能够做得更加隐形。
只有在隐私保护和合规处理都落实妥当之后,真正的竞争优势才会像前文所说的那样,落到一个问题上:
谁的 AI 更懂你?
这也是为什么除了 AI 会议记录以外,几乎所有 AI 助手类产品都在疯狂收集用户的业务「上下文」。
毕竟,还有什么能比会议记录提供更理想的业务「上下文」呢?
高效搞定事情,尽情享受生活

